Wie unser Kontext-Layer mitwächst
Wie wir Firmenwissen für KI aufbauen, finden lassen und aktuell halten.
Herzlich Willkommen zu den AI FIRST Insights! Letzte Woche habe ich dir die komplette Architektur unseres KI-Betriebssystems 2.0 gezeigt. Heute gehen wir tiefer in einen der wichtigsten Bausteine: den Kontext-Layer. Damit meine ich alles Firmenwissen, das unser Agent bei der Arbeit liest, und wie wir es aufbauen und pflegen.
Für die Version 2.0 war eine der wichtigsten Fragen: Wie bleibt der Kontext richtig, wenn sich die Firma jede Woche verändert?
Heute zeige ich dir:
- warum Kontext der größte Hebel ist,
- wie unser Kontext-Layer aufgebaut ist und warum genau so,
- wie der Agent darin findet, was er braucht,
- und wie der Kontext aktuell bleibt, ohne dass wir ständig hinterherschreiben.
Los geht's!
Warum Kontext der größte Hebel ist
Eine KI weiß nichts über dein Unternehmen, und sie lernt auch nichts dazu: Jede Aufgabe beginnt für den Agenten bei null. Aber wenn KI Zugriff auf den gleichen Kontext hat, den auch die Menschen haben, die für bestimmte Aufgaben verantwortlich sind, kann sie einen Großteil der digitalen Aufgaben ausführen oder sehr gut unterstützen.
Die Menge und Qualität des verfügbaren Kontexts ist der größte Treiber für den Einfluss, den KI auf deine Arbeit und dein Unternehmen haben kann.
Daraus folgen drei Prinzipien:
- KI kann nur nutzen, was aufgeschrieben ist: Alles Implizite, das in Köpfen, Chats und alten Dokumenten steckt, muss explizit werden. Die ganze Firma muss „lesbar“ für KI sein. Das predige ich immer wieder.
- Was der Agent liest, hält er für wahr: Steht dort ein veralteter Preis, arbeitet er damit, und die Ergebnisse werden falsch. Die Qualität und Aktualität vom Kontext beeinflusst also jede Aufgabe von KI enorm.
- Die KI mieten, den Kontext besitzen: Heute sehen wir mit Claude die beste Leistung, morgen ist es vielleicht ein anderer Agent. KI kann austauschbar sein, aber unser Firmenwissen müssen wir immer mitnehmen können. Der Kontext-Layer ist also so aufgebaut, dass jede KI damit arbeiten kann.
Unser Kontext-Layer muss drei Aufgaben lösen:
- Finden: Der Agent findet das richtige Wissen, ohne alles zu lesen.
- Anreichern: Neues Wissen kommt hinein, wenn sich die Firma verändert.
- Aktuell halten: Was nicht mehr gilt, fliegt raus, bevor der Agent damit arbeitet.
In Version 1 hatten wir das Finden und Anreichern mitgedacht, aber wir sind am Aktuell-Halten gescheitert. Irgendwann war die Realität eine andere als das, was im Kontext stand.
Genau darauf ist Version 2.0 gebaut.
Wie aus einzelnen Experimenten ein AI FIRST Unternehmen wird
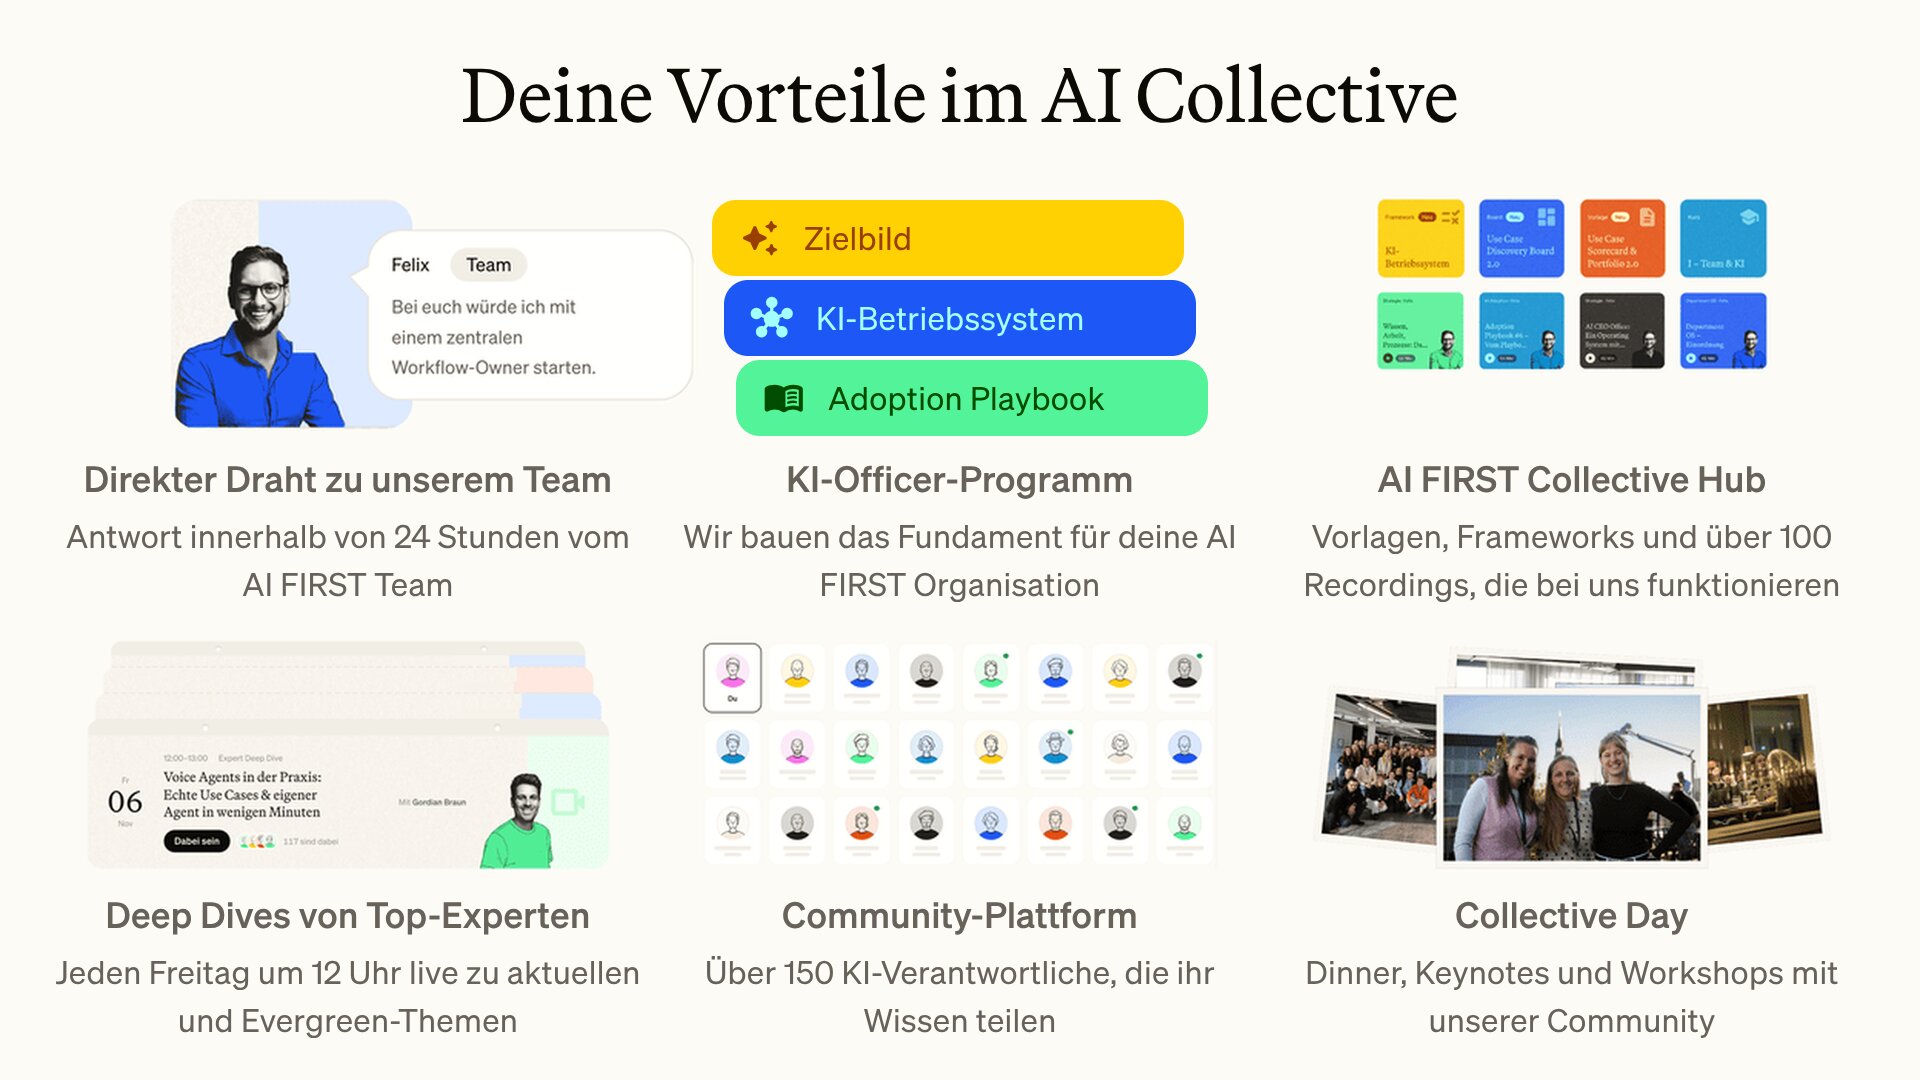
Im AI Collective teilen wir nicht nur unseren Blueprint für den Aufbau eines KI-Betriebssystems.
Du startest mit dem KI-Officer-Programm: zwölf Wochen, in denen wir gemeinsam dein Zielbild entwickeln, ein KI-Betriebssystem für eine Abteilung bauen und zeigen, wie diese neue Arbeitsweise im Unternehmen ankommt.
Anschließend unterstützen wir dich bei der Transformation zum AI FIRST Unternehmen:
- jeden Freitag eine hands-on Live-Session, regelmäßig mit externen Experten
- direkter Zugang zu mir und meinem Team, Antwort innerhalb von 24 Stunden
- alle Vorlagen aus unserem Collective Hub und über 100 Recordings
- Community Events wie unser Collective Day in Hamburg
Nur 30 Plätze, first come first served. Bewerben kannst du dich noch bis zum 15. November.
So ist unser Kontext-Layer 2.0 aufgebaut
Unser Kontext-Layer besteht aus zwei Teilen: Einem Wiki und unseren Tools/Quellsystemen.
Die Grundregel lautet: Ins Wiki kommt, was dauerhaft gilt. Was gerade passiert, bleibt im Tool.
Unser Angebot, unsere Prozesse, der Ablauf eines Programms, wie wir schreiben: Das steht als Textdatei in GitHub (unserem Wiki). Kundendaten, Mails, Meeting-Notizen, laufende Projekte und Zahlen bleiben in Notion, Attio, Gmail oder Qonto (unseren Tools). Dort liest der Agent sie live, mit den Rechten der Person, für die er arbeitet.
Wer was sehen darf
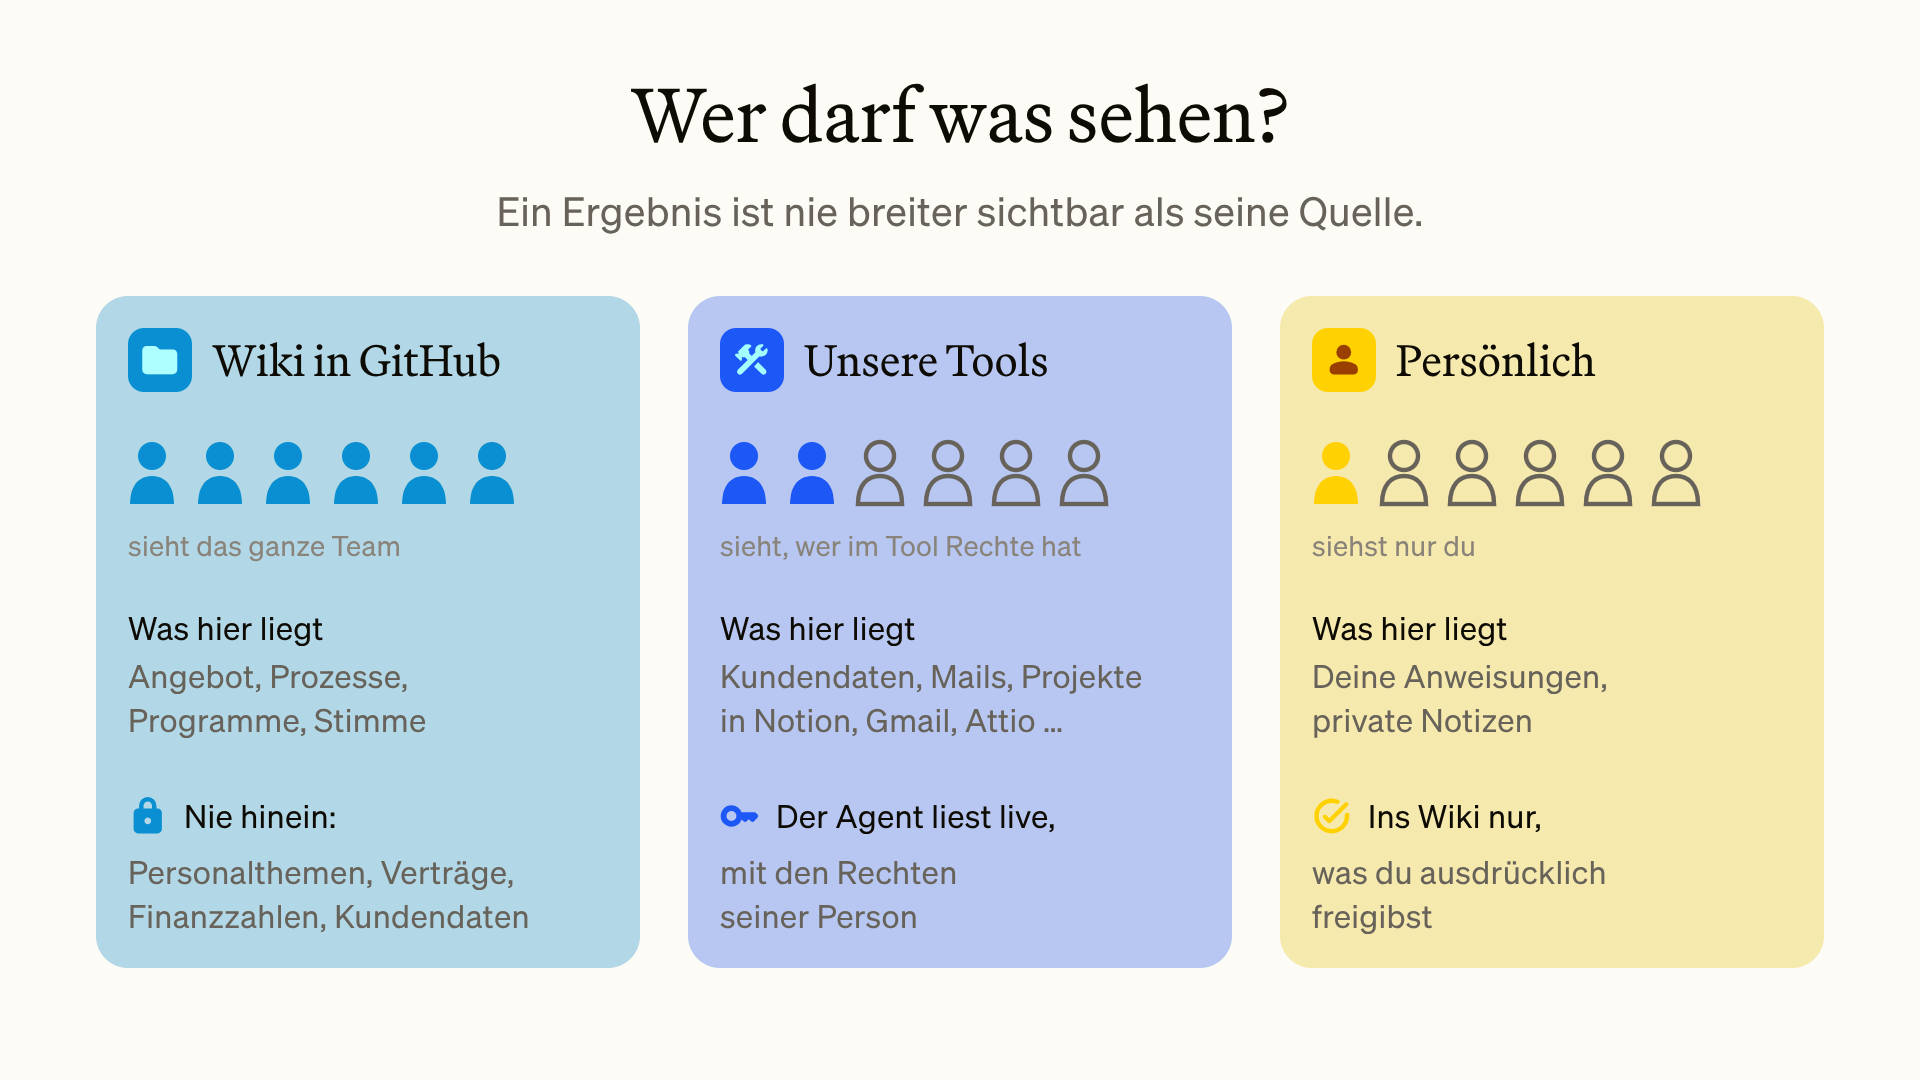
Ein Riesenthema beim Aufbau war: Wer darf eigentlich was sehen? Das Wiki sieht das ganze Team. Was der Agent dort hineinschreibt, ist also für alle sichtbar.
Deshalb gilt bei uns ein Grundsatz: Ein Ergebnis ist nie breiter sichtbar als seine Quelle. Fasst der Agent eine Mail aus meinem Postfach zusammen, landet diese Zusammenfassung nicht im Wiki, auch wenn sie noch so nützlich wäre.
So setzen wir das um:
- Der Agent arbeitet mit den Rechten seiner Person: Jede Person meldet sich in Notion, Gmail oder Attio mit ihrem eigenen Konto an. Ihr Agent sieht genau das, was sie selbst sieht. Ist eine Notion-Seite für sie nicht freigegeben, findet auch ihr Agent sie nicht.
- Rechte vergeben wir nur im Tool selbst: Wer was sehen darf, regeln wir weiter an einer Stelle, so wie bisher. Fehlt dem Agenten ein Zugriff, sagt er das und sucht keinen Umweg.
- Manches kommt nie ins Wiki: Was das ist, steht als feste Liste in GitHub: Personalthemen, Gehälter, Vertragsdetails, Finanzzahlen, Preise einzelner Kunden, Personendaten und Zugangsdaten. Erkennt ein kleines Prüfprogramm so etwas beim Schreiben, stoppt es den Agenten.
Das Wiki wird nur von der KI gepflegt
Die meisten Firmen-Wikis funktionieren nicht. Am Anfang ist alles sauber sortiert. Dann legt jemand einen zweiten Ordner an, der fast so heißt wie der erste, Seiten veralten, und keiner traut sich, etwas zu löschen. Irgendwann findet niemand mehr etwas, und das Wiki wird nicht mehr benutzt.
Woran es scheitert, ist die Pflege, die im Alltag immer liegen bleibt.
Deshalb pflegt bei uns die KI das Wiki. Sie sortiert neues Wissen an der richtigen Stelle ein, ändert alte Aussagen, wenn sich etwas geändert hat, und meldet, wo sich zwei Dateien widersprechen. Menschen schreiben selbst nichts hinein. Sie sagen dem Agenten, was gilt, und er pflegt es ein. Den Ansatz beschreibt Andrej Karpathy in seinem LLM-Wiki, den wir für uns adaptiert haben.
Jeder Bereich hat einen Besitzer, meist ist das die Bereichsleitung. Sie entscheidet, welcher Kontext dort gilt.
Ein Ordner je Bereich, eine Datei je Thema
So sieht das in GitHub aus: Je Arbeitsgebiet gibt es einen Ordner, etwa Firma, Sales, Enablement oder Marketing. Darin liegt je Thema genau eine Datei, zum Beispiel unser Angebot, unser Sales-Prozess oder wie wir Mails schreiben.
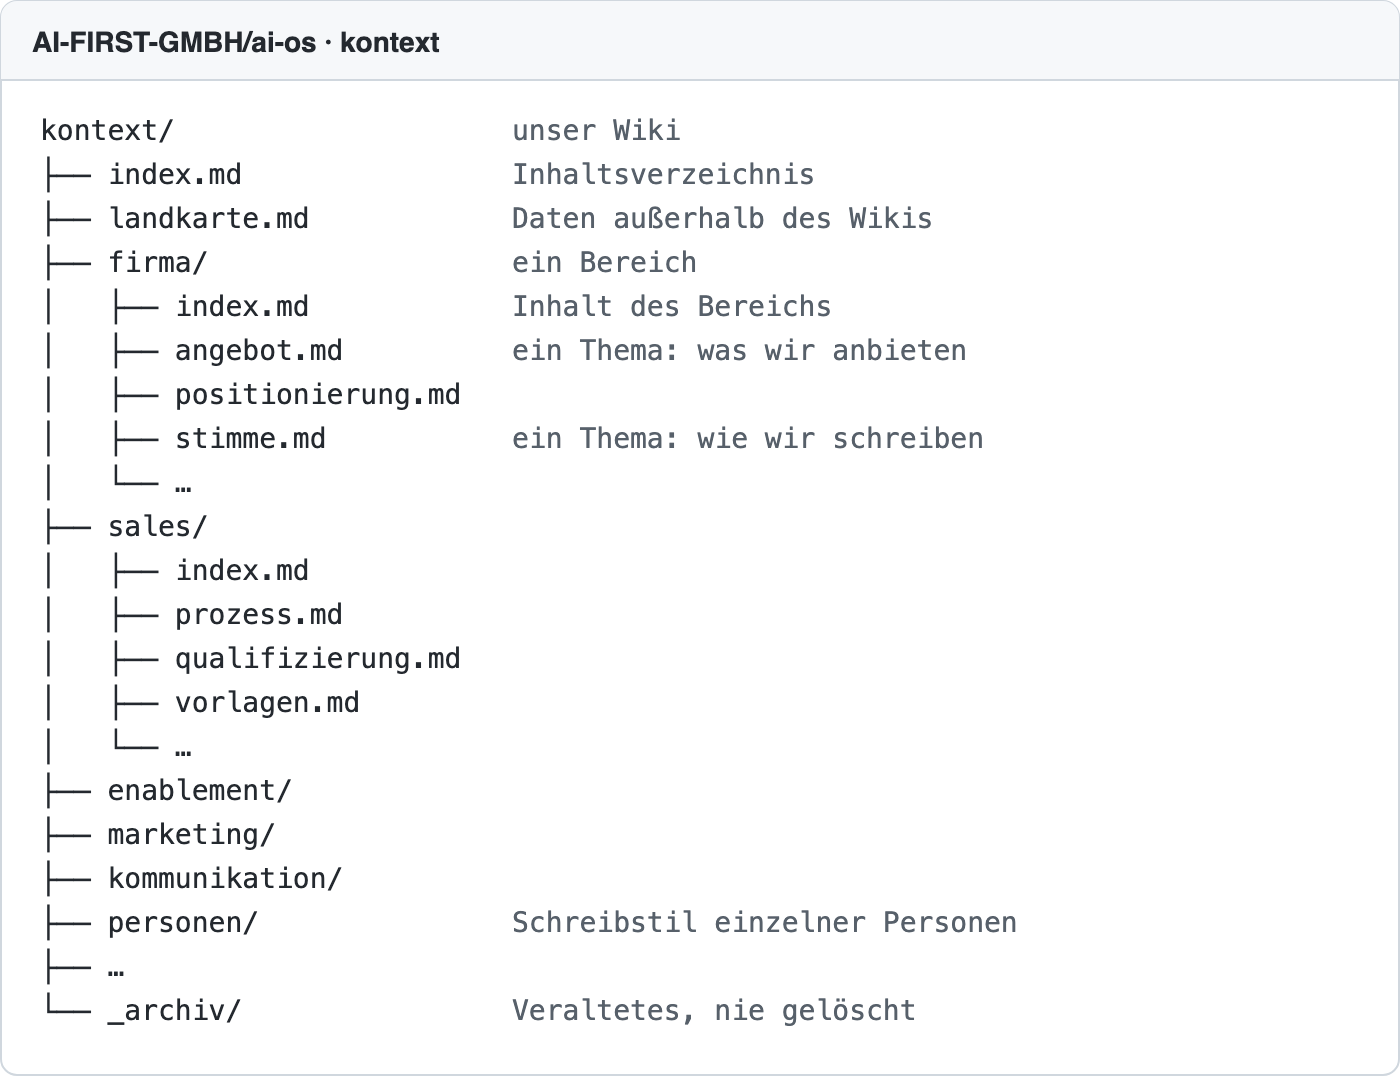
Warum so kleinteilig? Damit der Agent nur liest, was die Aufgabe braucht. Läge alles zu Sales in einer großen Datei, müsste er sie für jede Mail komplett lesen. Und je mehr er liest, desto schlechter bleibt er bei der eigentlichen Aufgabe.
Solch eine Struktur aus Ordnern und Dateien ist in dutzenden Tools abbildbar — das kann auch Sharepoint, ein Drive oder ein Tool wie Obsidian sein. GitHub funktioniert für uns gut, weil dort auch der Code für unsere selbst-entwickelten Tools dokumentiert ist.
Wie eine Datei aufgebaut ist
Jede Datei ist gleich aufgebaut. Hier zum Beispiel unsere Regeln für Mail-Entwürfe:
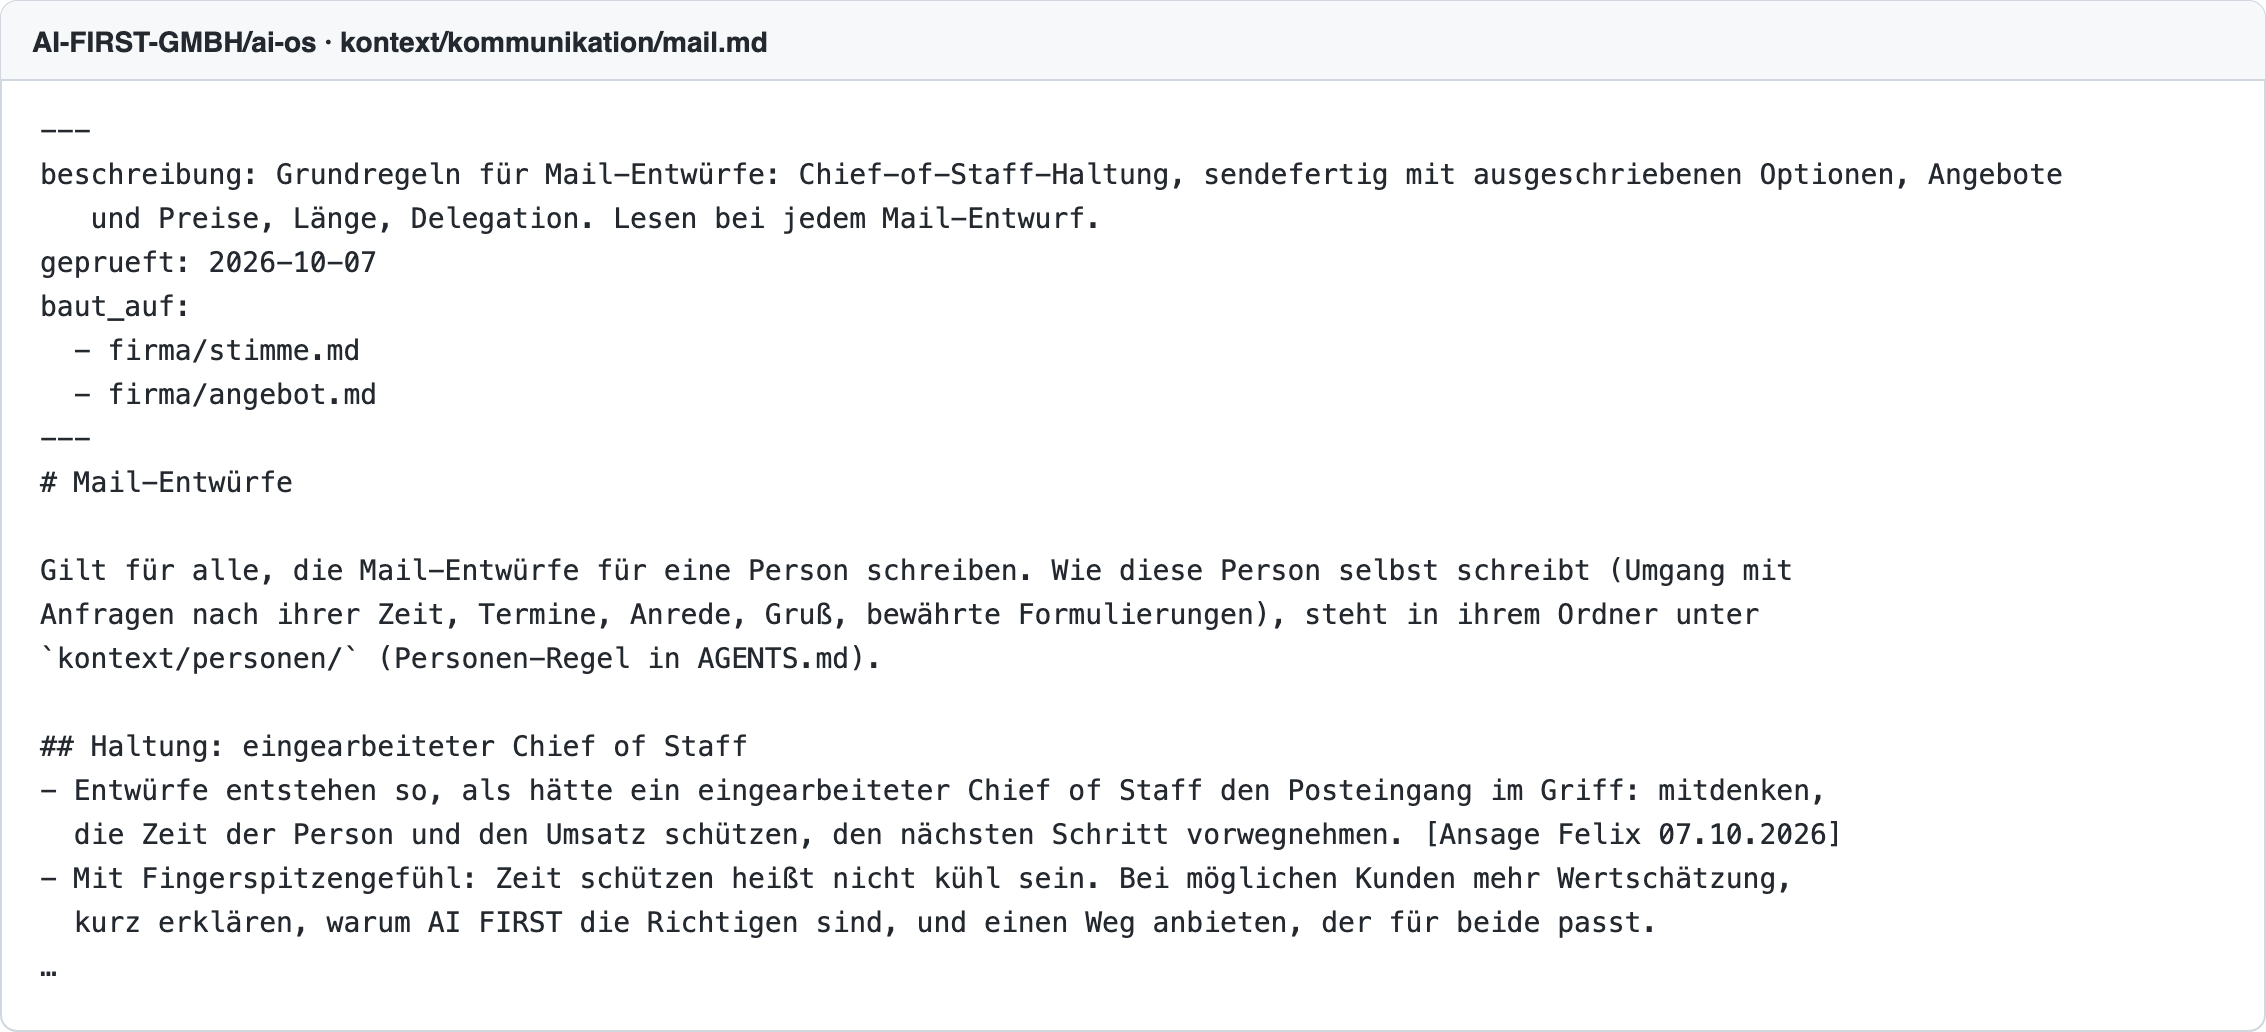
- Oben steht eine kurze Beschreibung: was in der Datei steht und bei welcher Aufgabe man sie braucht. Daran erkennt der Agent, ob er sie öffnen muss.
- Darunter das Prüfdatum: wann der Besitzer den Inhalt zuletzt bestätigt hat. Liegt das zu lange zurück, meist 90 Tage, wird die Datei zur Prüfung fällig.
- Dazu, worauf die Datei aufbaut: Die Mail-Regeln bauen zum Beispiel auf unserem Angebot auf. Ändern wir die Preise, weiß das System, dass die Mail-Regeln mitgeprüft werden müssen.
- Hinter jeder Aussage steht ihre Quelle, etwa „Ansage Felix 07.10.2026“. Keine Quelle, kein Eintrag. So lässt sich alles nachprüfen, und die KI kann nichts dazudichten.
Eine Datei sagt immer nur, was jetzt gilt. Ändert sich etwas, wird die alte Aussage ersetzt, nicht ergänzt. Denn der Agent liest bei jeder Aufgabe alles mit, was in der Datei steht. Stünde die alte Regel neben der neuen, würde er leicht die falsche nehmen. Verloren geht trotzdem nichts, denn GitHub merkt sich jede frühere Fassung.
Index und Landkarte
Damit der Agent nicht alle Dateien lesen muss, gibt es zwei Verzeichnisse.
Der Index ist das Inhaltsverzeichnis des Wikis. Zu jeder Datei steht dort ein Satz, was drinsteht und wann man sie braucht. Der Agent liest den Index zuerst und springt dann direkt in die richtige Datei. Hier zum Beispiel der Index unseres Marketing-Bereichs:
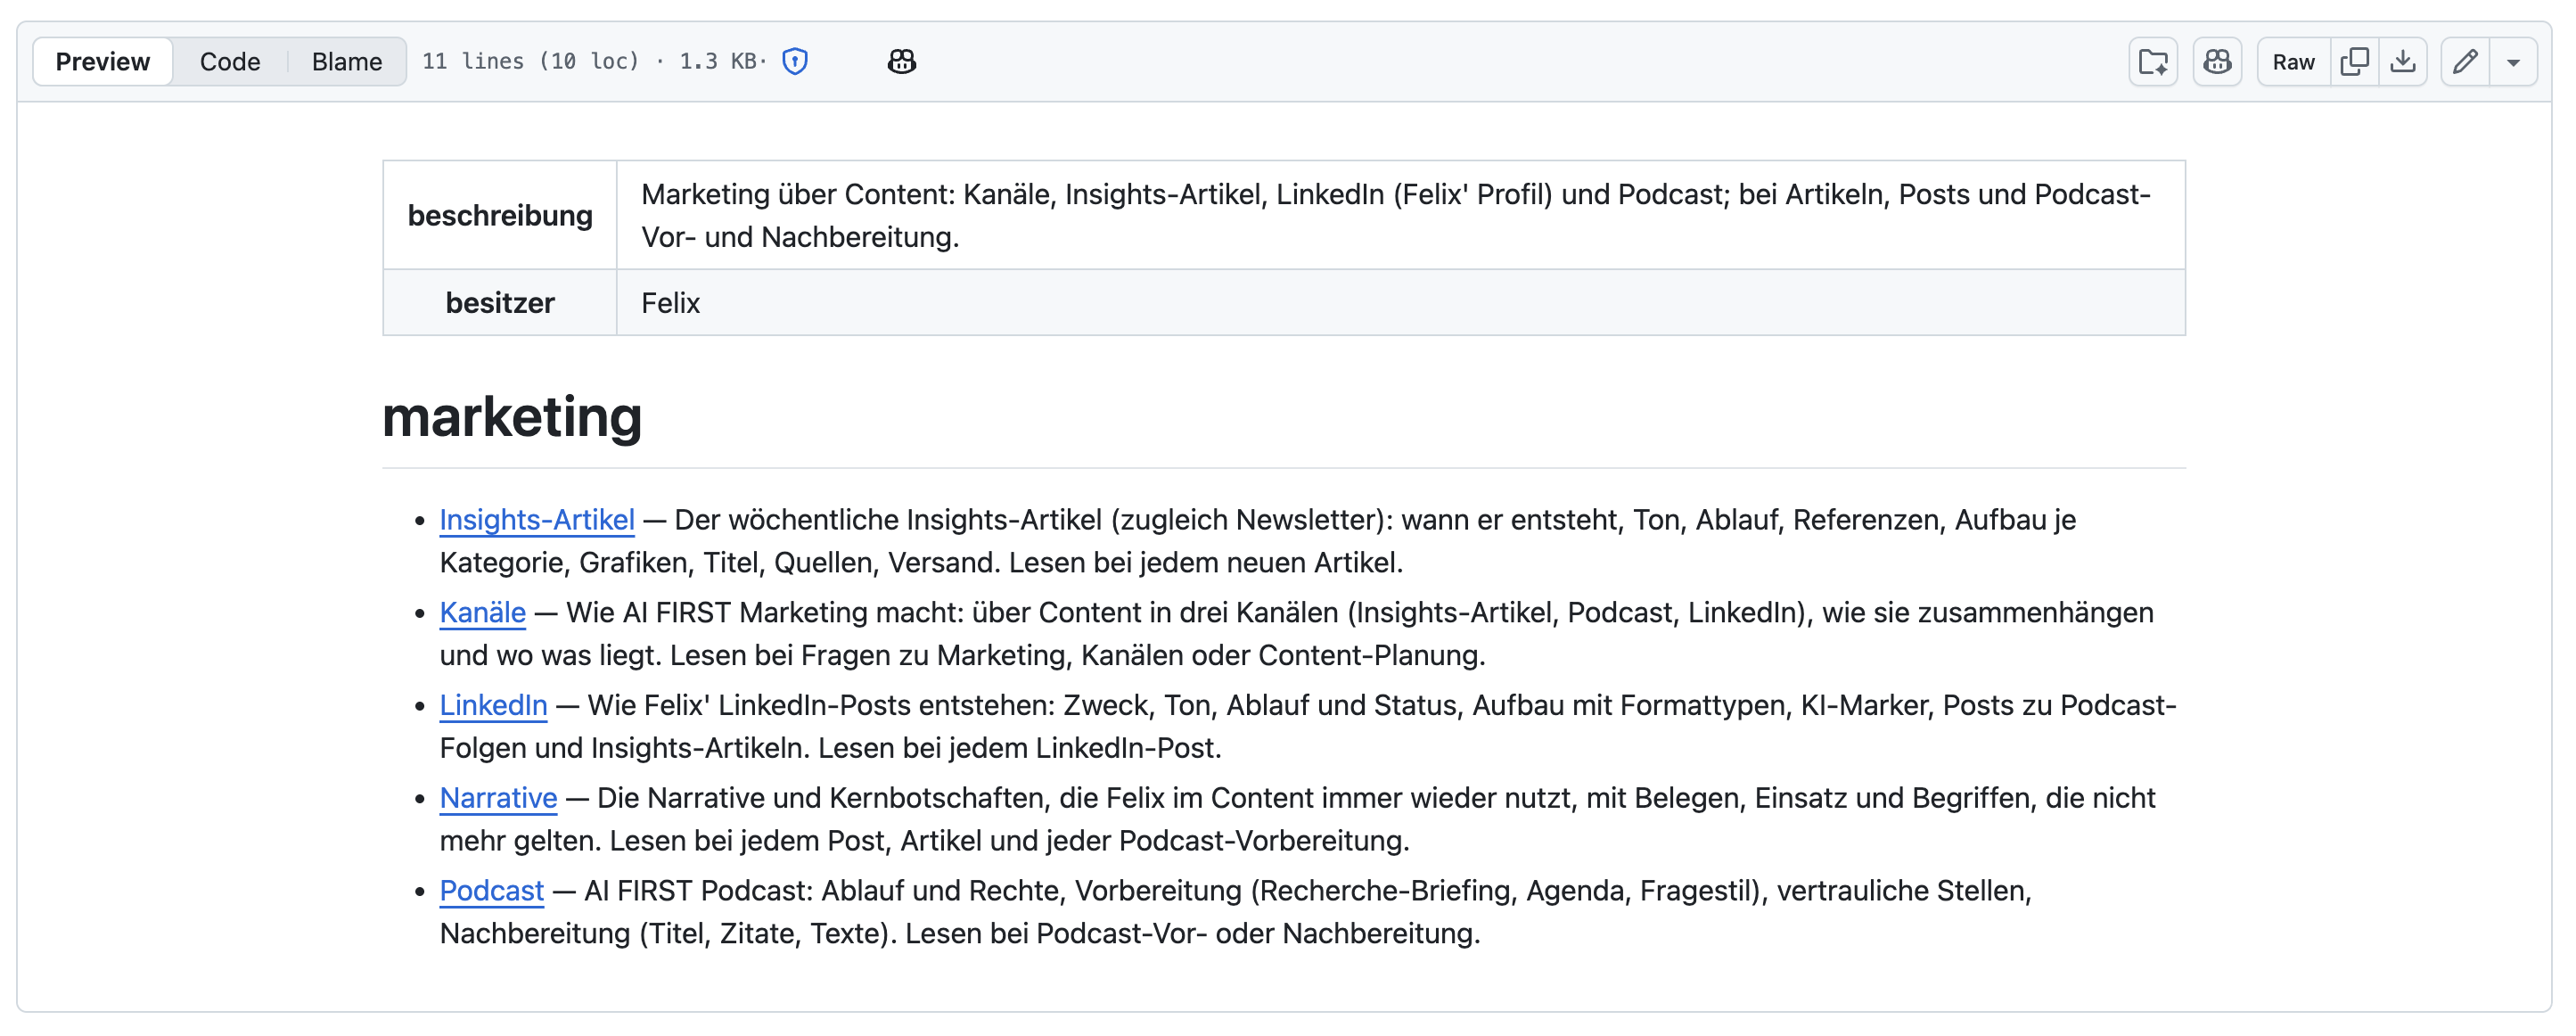
Niemand pflegt den Index von Hand. Er entsteht automatisch aus den Beschreibungen oben in den Dateien, denn ein Inhaltsverzeichnis, das Menschen pflegen, veraltet als Erstes.
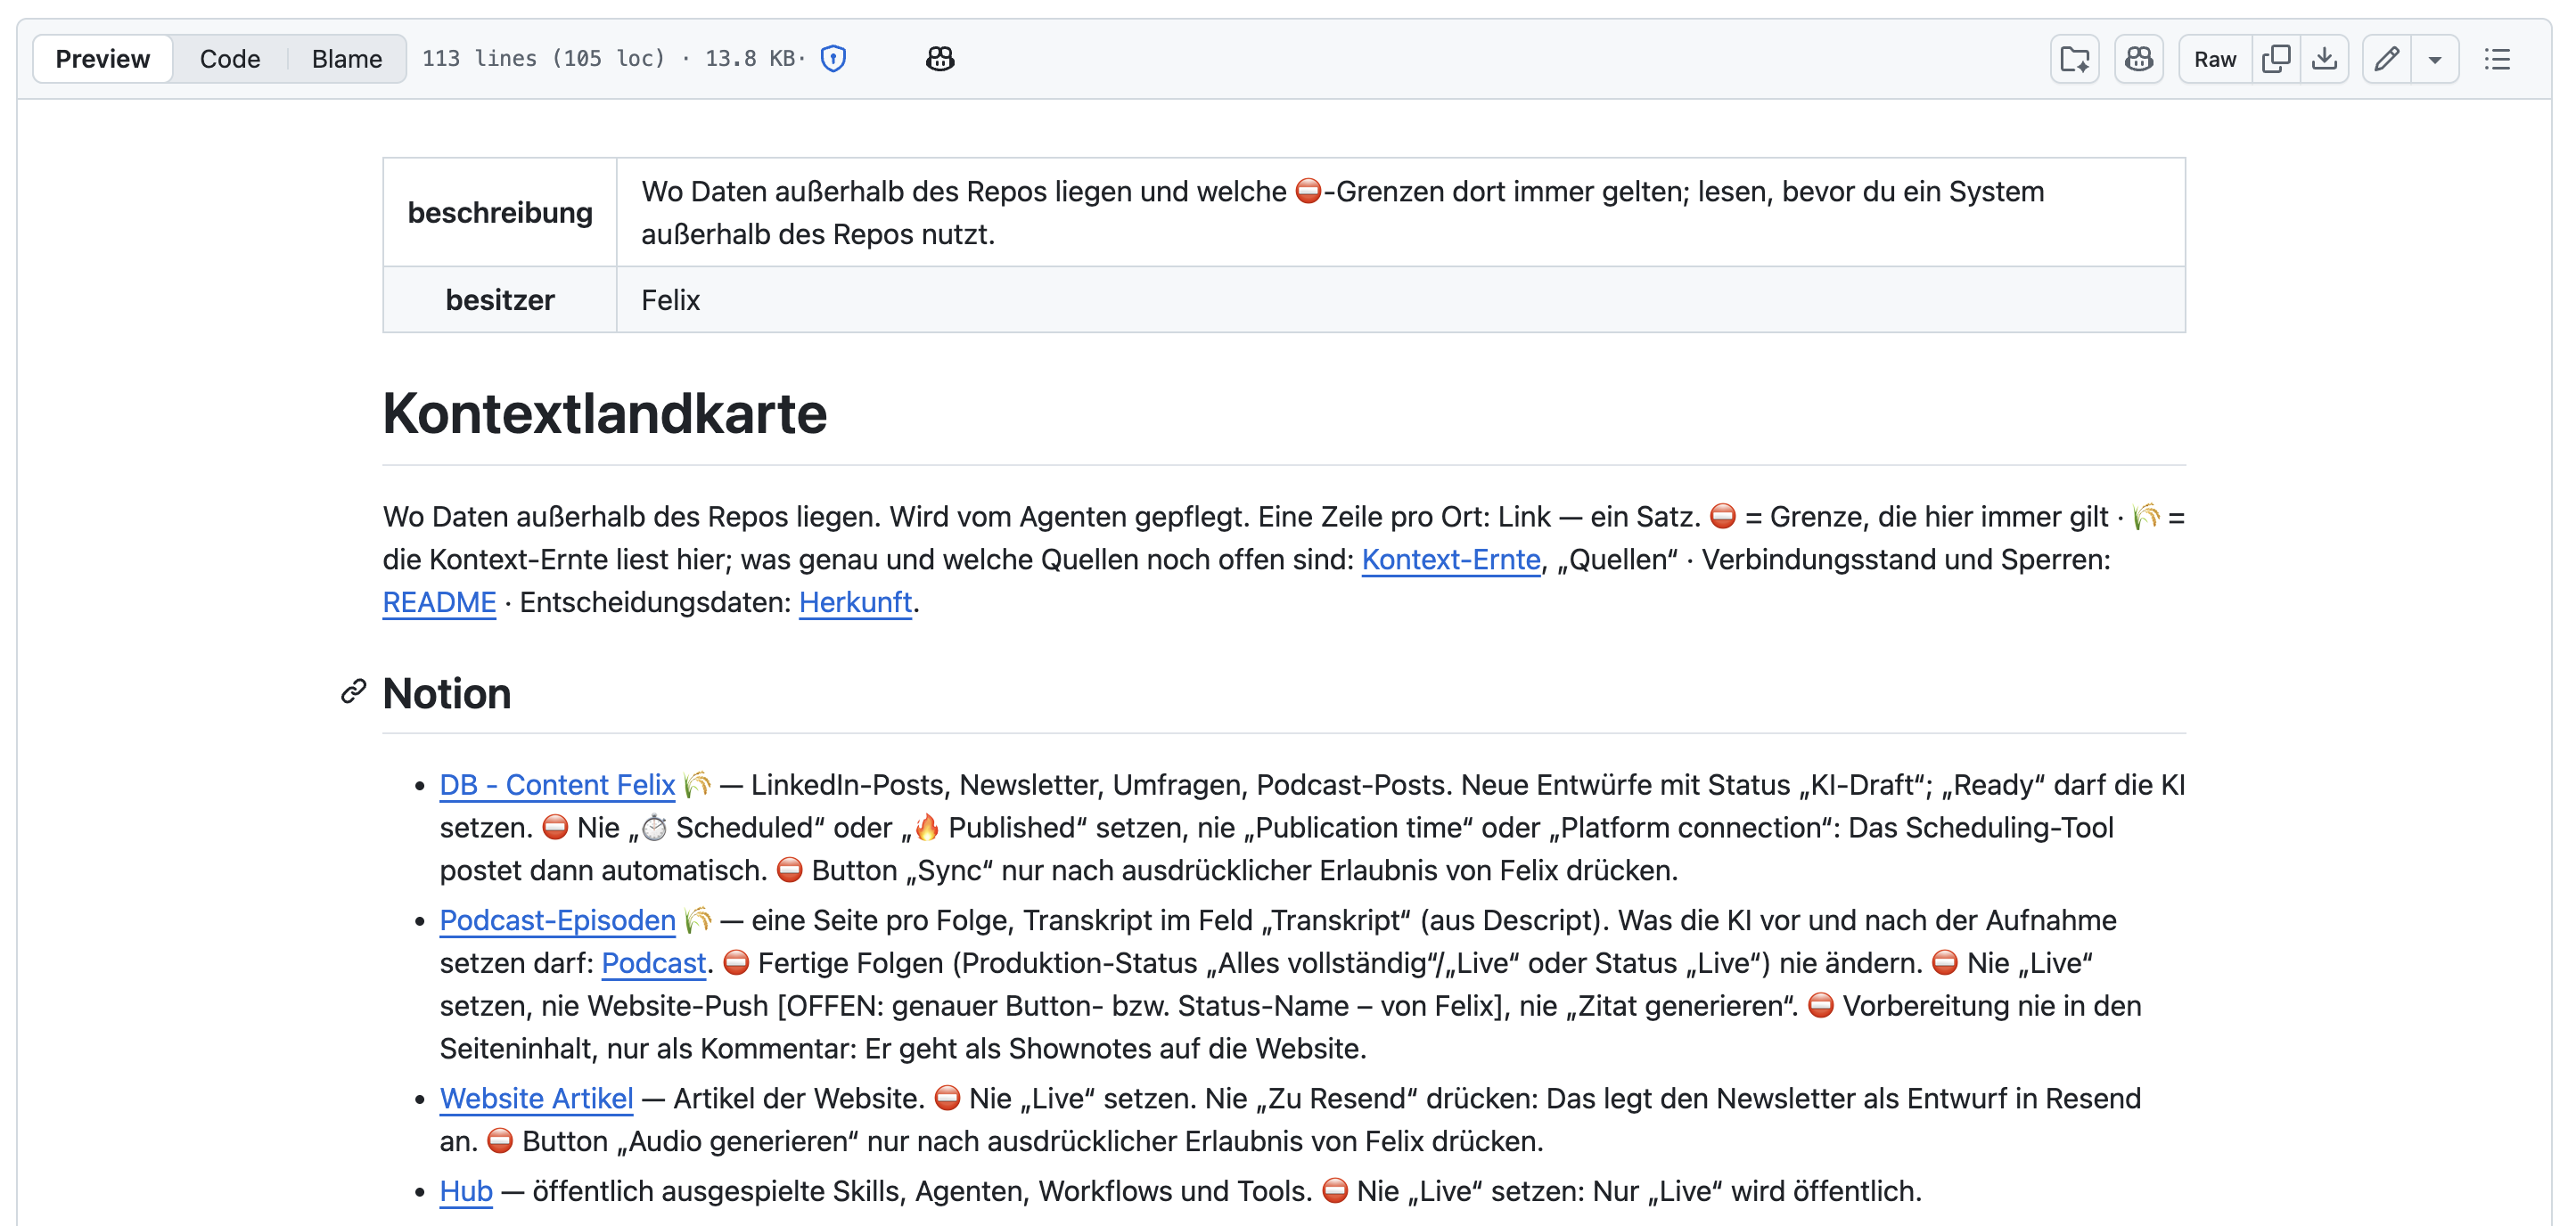
Die Landkarte verzeichnet alles außerhalb des Wikis: welche Notion-Datenbank wofür da ist, was in Attio liegt, welcher Kalender live gelesen wird. Zu vielen Orten steht dort auch, was der Agent in den Drittsystemen nie tun darf.
Wie der Agent den Kontext findet und nutzt
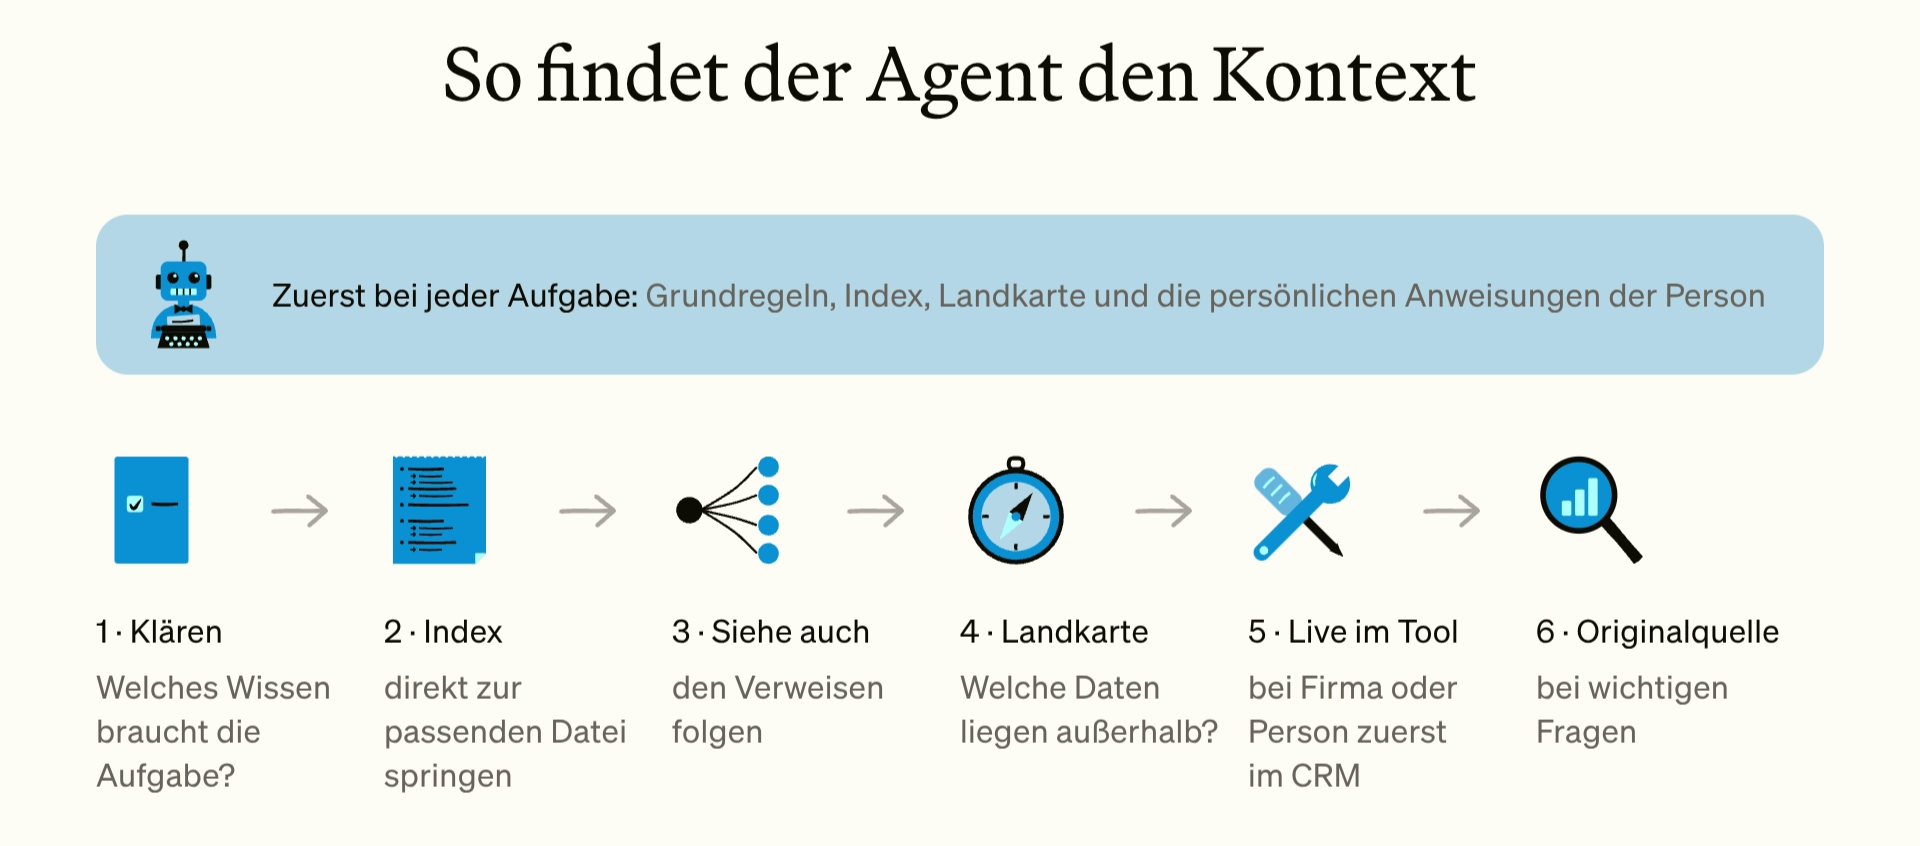
Bei jeder Aufgabe liest der Agent zuerst nur vier Dateien: unsere Grundregeln, den Index, die Landkarte und die persönlichen Anweisungen der Person, für die er arbeitet. Alles andere holt er sich in fester Reihenfolge, wie sie in unseren Grundregeln steht:
- Klären, welches Wissen die Aufgabe braucht.
- Im Index direkt zur passenden Datei springen.
- Den Verweisen unter „Siehe auch“ folgen.
- In der Landkarte nachsehen, welche Daten außerhalb liegen.
- Live im Tool suchen, bei einer Firma oder Person zuerst in unserem CRM Attio.
- Bei wichtigen Fragen die Originalquelle lesen.
Was danach fehlt, erfindet er nicht. Er markiert die Lücke, etwa als [OFFEN: Preis für Paket X], oder fragt nach.
So sieht das bei einer Anfrage über unsere Website aus: Im Index findet der Agent den Bereich Sales, „bei Vertriebsfragen und Anfragen“. Er liest, woran wir erkennen, ob ein Lead passt, und unsere Vorlage für die erste Antwort. Für die Mail kommen die Mail-Regeln von oben dazu, über „Baut auf“ unser Angebot und, weil er für mich schreibt, mein eigener Mail-Stil. Die Firma schlägt er live in Attio nach. Am Ende liegt ein Entwurf in Gmail, und jede Aussage darin lässt sich auf eine Datei zurückführen.
Die Arbeit prüft den Kontext mit: Stößt der Agent auf einen Fakt, der im Wiki fehlt oder ihm widerspricht, legt er im Logbuch einen Kontext-Hinweis an. Das Logbuch ist eine Liste in Notion, in der das System festhält, was es getan hat. Den holt die Kontext-Ernte am nächsten Morgen ab.
Wir testen, ob der Agent richtig findet: Für das Wiki gibt es rund 100 Testfragen, jede mit der Datei, in der die Antwort steht. Ein frischer Agent ohne Vorwissen beantwortet sie, ein Programm wertet aus, ob er die richtige Datei gelesen hat. Ziel sind mindestens 90 Prozent.
Wie der Kontext aktuell bleibt
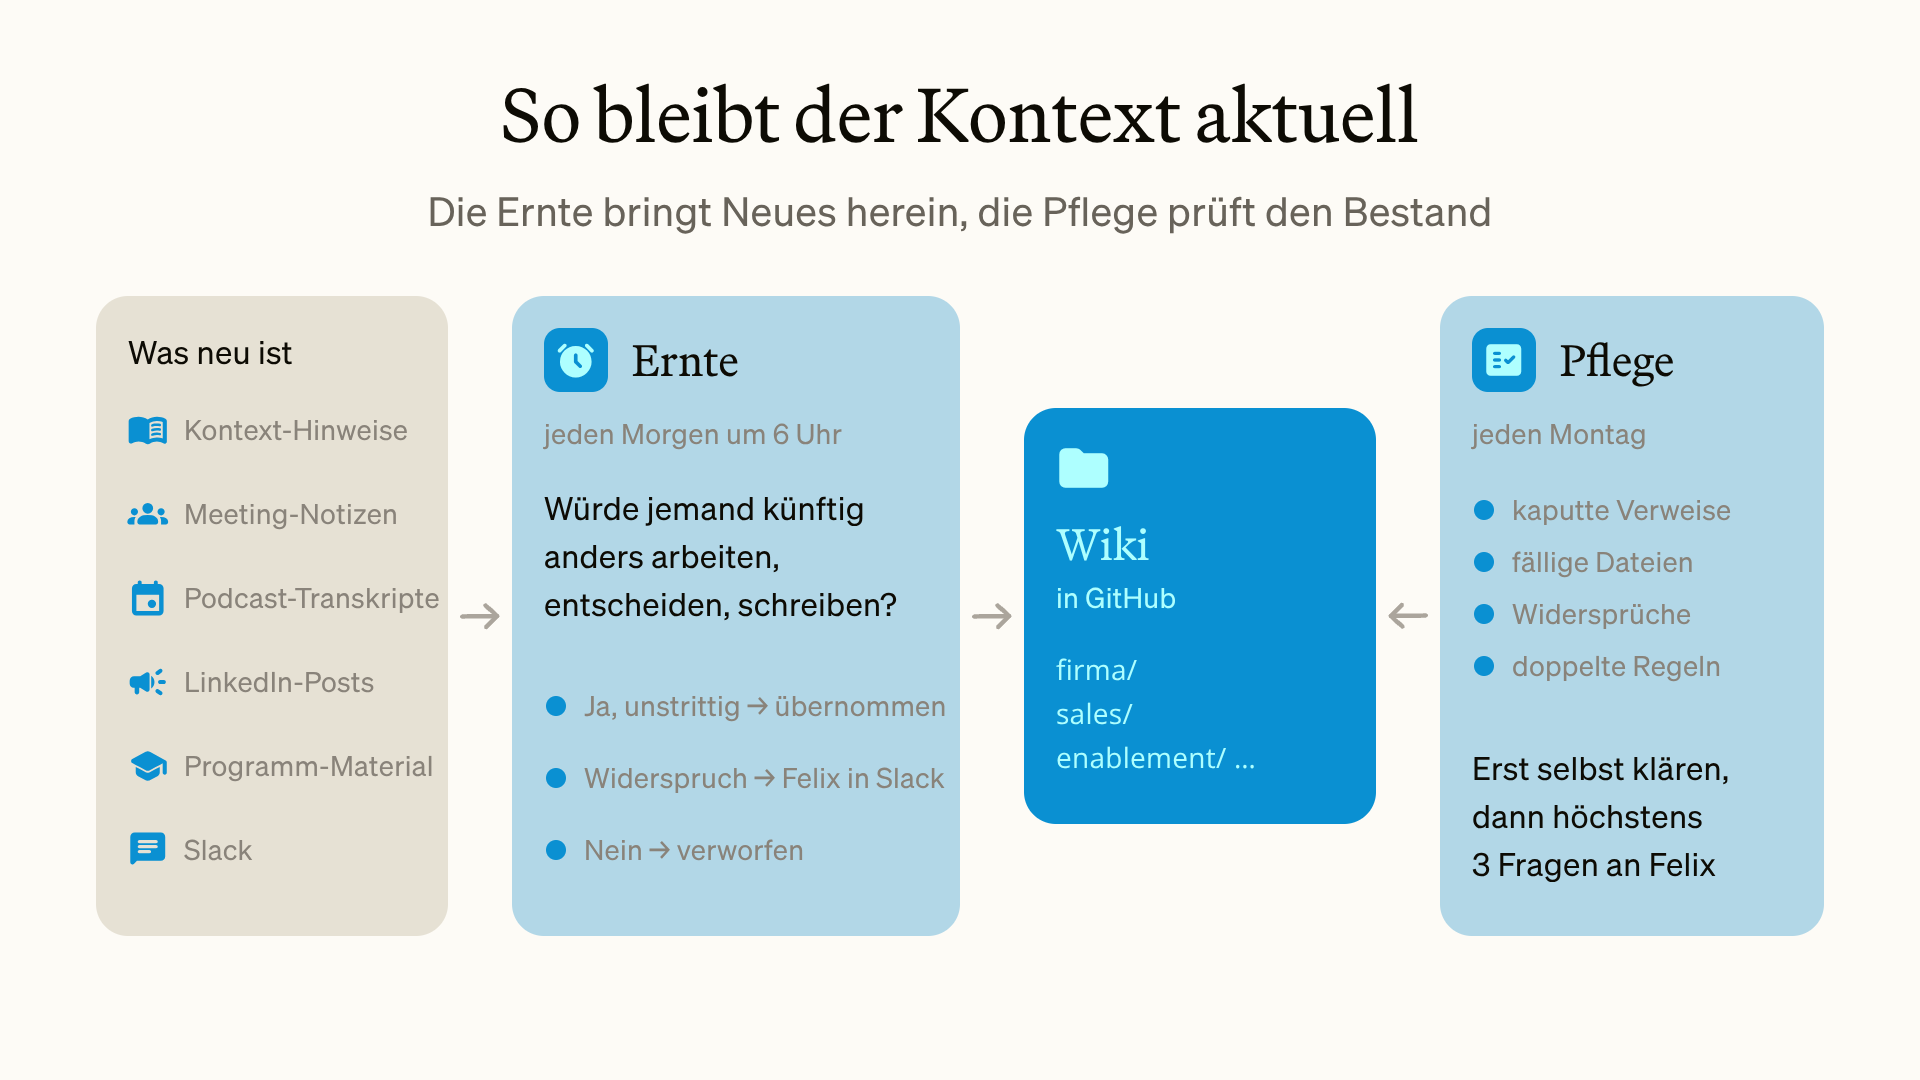
Hier ist Version 1 gescheitert. Heute kommt Wissen auf mehreren Wegen hinein: Ich sage im Chat „Das gilt ab jetzt …“, jemand aus dem Team schreibt in Slack „Fürs Wiki: …“, oder der Agent interviewt den Besitzer eines Bereichs und fragt nur, was in keiner Quelle steht. Den Rest erledigt eine Automatisierung in zwei Teilen: jeden Morgen die Kontext-Ernte, montags danach die Kontext-Pflege.
Die Kontext-Ernte: jeden Morgen um 6 Uhr
Jeden Morgen liest der Agent alles, was seit dem letzten Lauf neu ist: die Kontext-Hinweise aus dem Logbuch, unsere internen Meeting-Notizen, Podcast-Transkripte, veröffentlichte LinkedIn-Posts, das Arbeitsmaterial unserer Programme in Notion und Slack.
Jede gefundene Aussage muss einen Test bestehen:
Würde eine Person oder ein Skill mit dieser Aussage künftig spürbar anders arbeiten, entscheiden oder schreiben?
Ist die Antwort nein, wird sie verworfen. Ich will im Wiki nur Wissen, das dauerhaft gilt, und es nicht mit kleinteiligen Fakten zumüllen. Was den Test besteht, sortiert der Agent:
- Neu und unstrittig: Er pflegt es ein, ein zweiter Agent prüft die Änderung, und sie wird übernommen, ohne dass ein Mensch sie ansehen muss.
- Widerspruch oder Grundlagen der Firma wie Angebot, Positionierung oder Stimme: Ich entscheide mit einer kurzen Antwort in Slack.
- Bereich einer anderen Person: Der Besitzer entscheidet, über den Änderungsvorschlag in GitHub oder mit einer Frage in seinem Slack-Kanal.
- Kunden- und Personendaten: kommen nie ins Wiki.
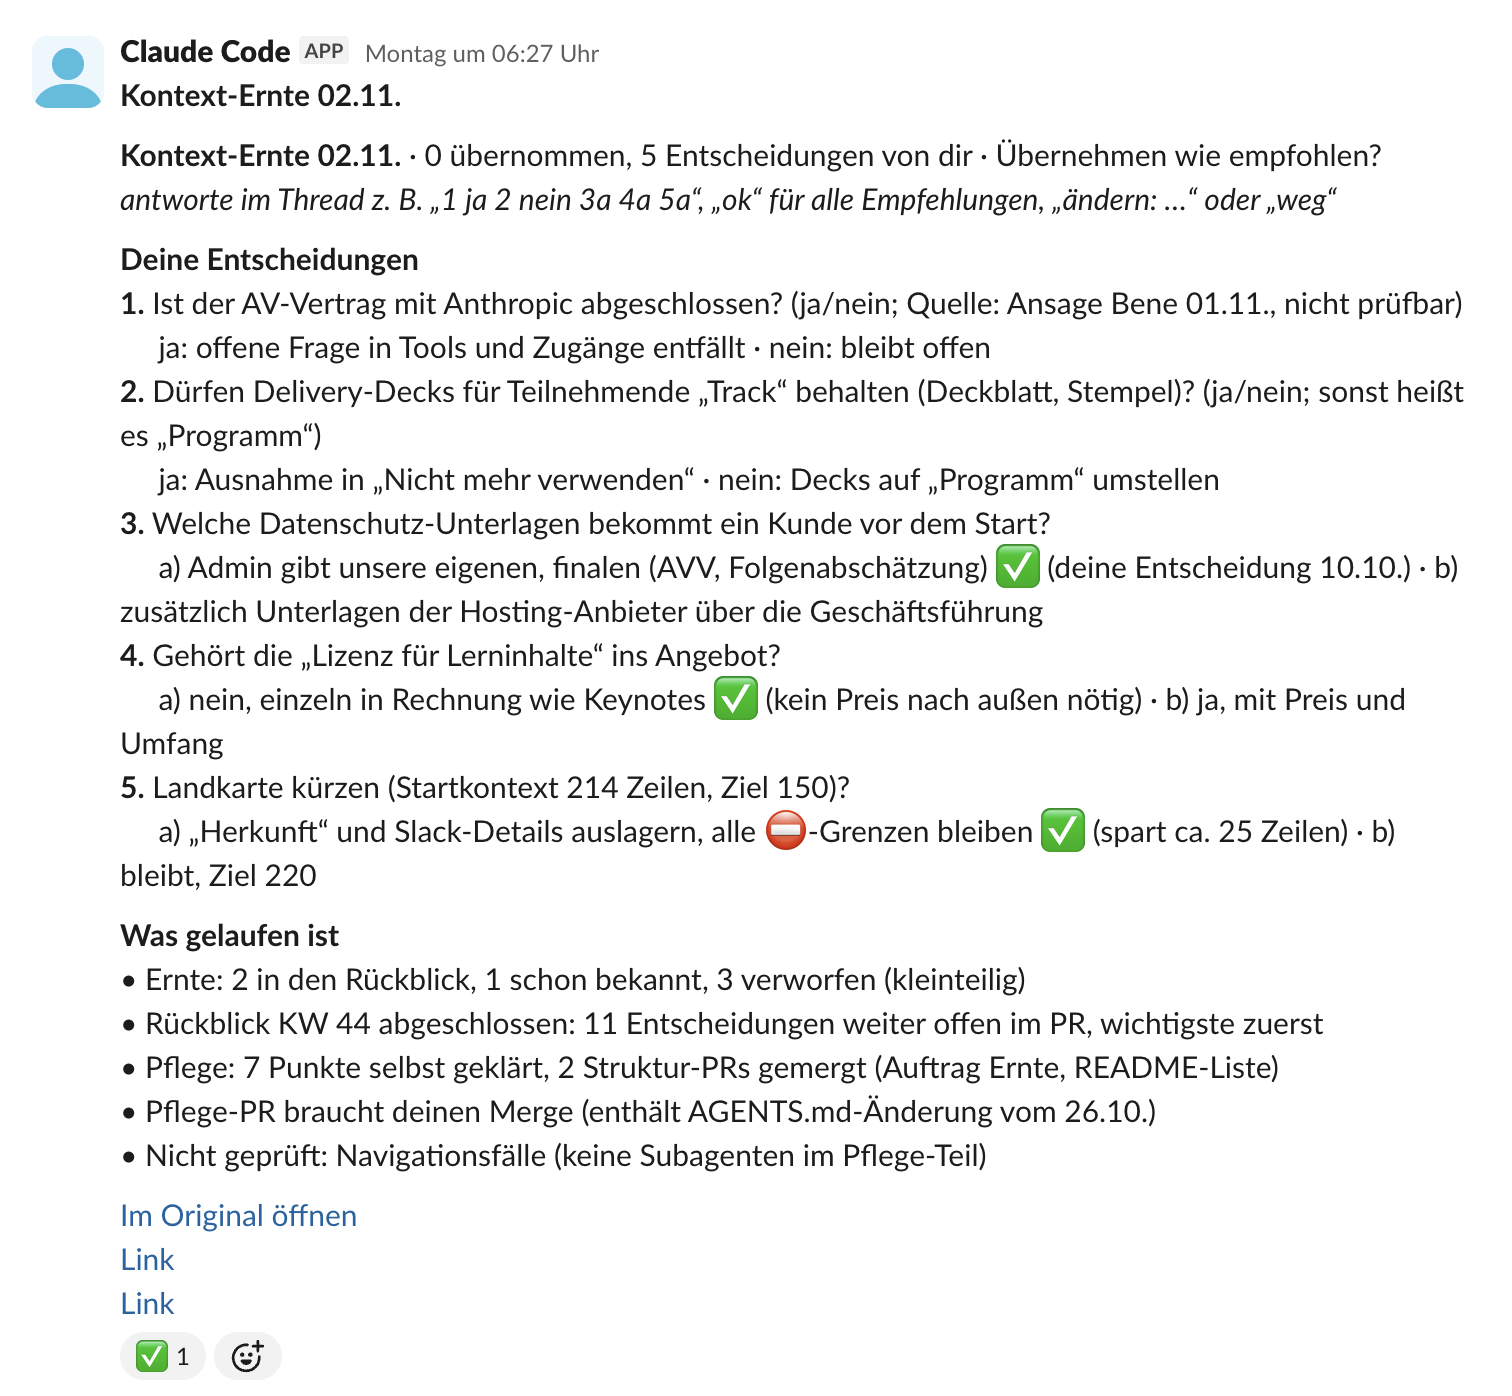
Die Kontext-Pflege: jeden Montag
Die Ernte bringt Neues herein, die Pflege prüft montags den ganzen Bestand. Ein Prüfprogramm findet kaputte Verweise, fehlende Angaben, veraltete Dateien und Dateien, auf die nichts mehr verweist. Der Agent sucht Widersprüche und doppelte Regeln, verdichtet zu lange Dateien und schlägt Veraltetes für das Archiv vor. Gelöscht wird nie.
Bevor er mich etwas fragt, versucht der Agent jeden Fund selbst zu klären: Ist das schon entschieden? Gibt es eine neuere Ansage mit Datum? Lässt es sich in GitHub belegen? Ist es nur Kleinkram wie Wortwahl oder Struktur? Erst wenn nichts davon greift, geht es zur Freigabe an den Besitzer.
Ändert sich eine Datei, prüft das System außerdem, welche anderen Dateien und Skills darauf aufbauen. Eine Änderung gilt erst, wenn alle davon mitgezogen sind oder begründet ist, warum sie weiter passen.
Seit dem Start der Ernte Mitte Oktober hat sich das Wiki rund 140-mal geändert. Gut ein Drittel davon kam über Ernte und Pflege, der Rest aus Ansagen und Onboardings im Alltag.
Fazit
Der Unterschied zwischen unserem Kontext-Layer 1.0 und 2.0 liegt in der Pflege. In Version 1 lag der Kontext in Notion. Wir hatten das Anreichern mitgedacht, kamen mit dem Aktuell-Halten aber nicht hinterher. Heute wird das Wiki von einem Agent sortiert, die Besitzer entscheiden, und eine Automatisierung holt jeden Morgen Neues herein und räumt jeden Montag Altes auf.
Wenn du deinen eigenen Kontext-Layer aufbaust, nimm diese Punkte mit:
- Trenne, was gilt, von dem, was passiert: Nur das Erste gehört in den Kontext, alles andere liest der Agent live.
- Lass die KI die Grundlage aufbauen: Ordner- und Dateistruktur sowie die Aufbereitung von vorhandenem Kontext (aus PDFs, PPTs, Transkripten, Mails, Chats, …) kann KI wunderbar übernehmen.
- Ein Thema, eine Datei, mit Quelle, Besitzer und Prüfdatum: Dann lässt sich jede Aussage prüfen, und Veraltetes fällt auf.
- Lass die KI schreiben und die Menschen entscheiden: Die Pflege ist genau die Arbeit, die Menschen liegen lassen.
- Plane die Pflege von Anfang an ein: Eine erste Automatisierung, die einmal täglich/wöchentlich neuen Kontext anreichert und alten aktualisiert.
Am Ende entscheidet der Kontext, ob KI für uns arbeitet oder wir für die KI.
Nächsten Sonntag geht es um Skills: wie sie aufgebaut sind, wie wir sie testen und warum es heute nur noch einen Bruchteil der Skills aus Version 1 gibt.
Bis nächsten Sonntag,
Felix