Warum wir unser KI-Betriebssystem neu gebaut haben
Was nach neun Monaten gebrochen ist, was gehalten hat und wie ich Version 2.0 gebaut habe
Herzlich Willkommen zu den AI FIRST Insights! Anfang 2026 haben wir unser 25-köpfiges KI-Agenten Team abgelöst und ein System gebaut, in dem KI bessere Arbeit machen kann: unser KI-Betriebssystem.
Nie zuvor haben wir so produktiv mit KI gearbeitet.
Neun Monate später habe ich (mal wieder) alles hinterfragt und die 2. Version unseres KI-Betriebssystems gebaut, um einige Probleme zu lösen, die sich in der Zwischenzeit heraus kristallisierten.
Heute zeige ich dir, was in diesen neun Monaten passiert ist: was funktioniert hat, was gebrochen ist, welche Fehler wir gemacht haben und was ich daraus gelernt habe. Das ist der Auftakt einer Serie, in der wir alle Bausteine unsere KI-Betriebssystems 2.0 beleuchten werden.
Am Ende habe ich auch noch ein paar News zum AI Collective in 2027.
Los geht’s!
Von Agenten zum Betriebssystem
Warum nochmal ein „KI-Betriebssystem“?
2024 haben wir begonnen die ersten KI-Agenten als digitale Mitarbeiter aufzubauen, da schon damalige simple Agenten-Funktionen mit den ersten Claude Sonnet Modellen in der Lage waren, über ihre Systemanweisung verschiedene mehrschrittige Aufgaben zu erledigen, wobei sie Kontext abgefragt und Tools ausgeführt haben. Die Welt wurde damit noch nicht verändert, aber eine Recherche, Kuratierung, Copywriting, Übersetzung und anschließende Dokumentation in einem Content Management Tool war schon drin — eigenständig.
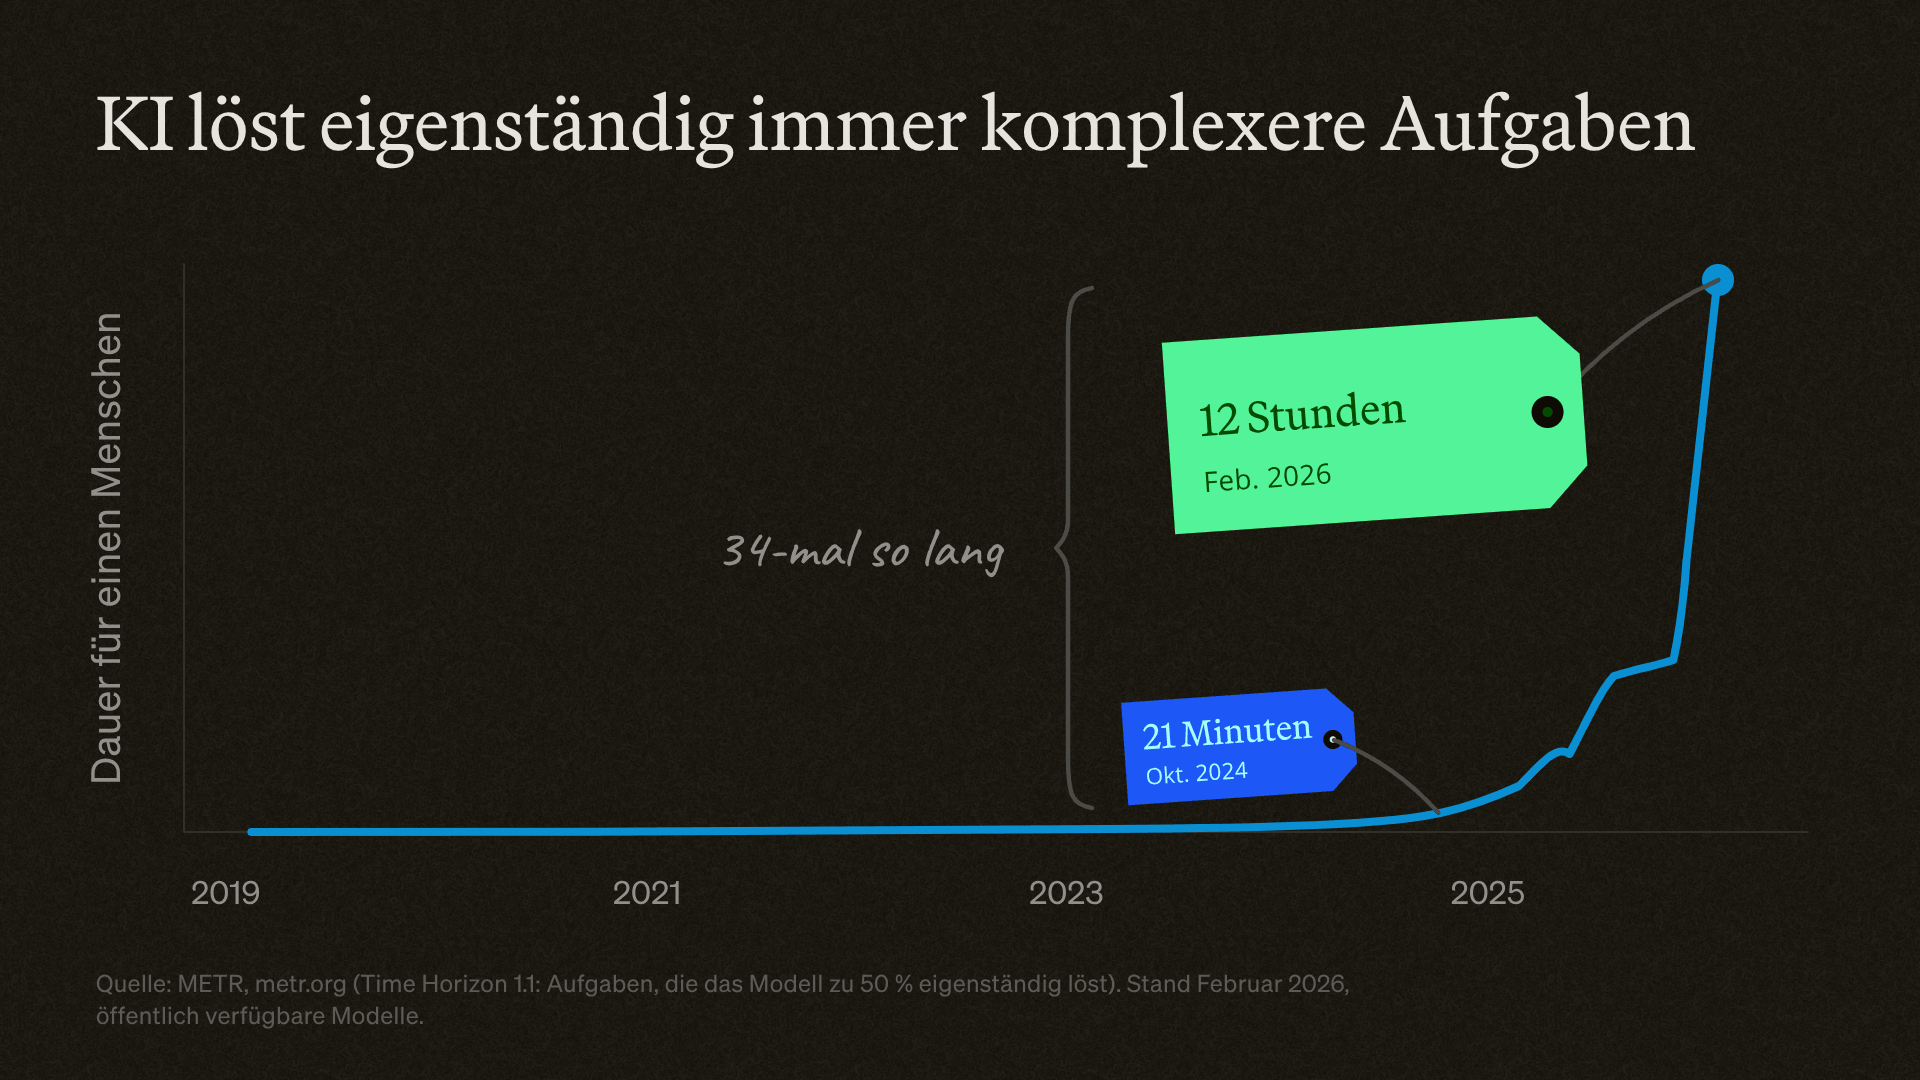
Das war der Moment, wo KI für uns vom Tool zum Mitarbeiter wurde. Recht zügig haben wir uns ein Team aus 25 KI-Agenten mit spezialisierten Rollen, Verantwortlichkeiten, Kontext und Tools aufgebaut.
Anfang 2026 machte KI dann ihren bis dato größten Entwicklungssprung. Modelle wie Opus 4.6 waren nun in der Lage über Stunden eigenständig an vielschrittigen Aufgaben zu arbeiten und dabei Kontext und Tools so zu kombinieren, bis das Ziel erreicht ist.
In diesem Moment gaben wir einem einzigen Agenten Zugriff auf alles (Anweisungen, Kontext, Tools der anderen 25 Agenten) und beobachteten, wie dieser eine Agent zuverlässig die unterschiedlichsten Aufgaben erledigte, ohne dass er dafür speziell „eingearbeitet“ wurde.
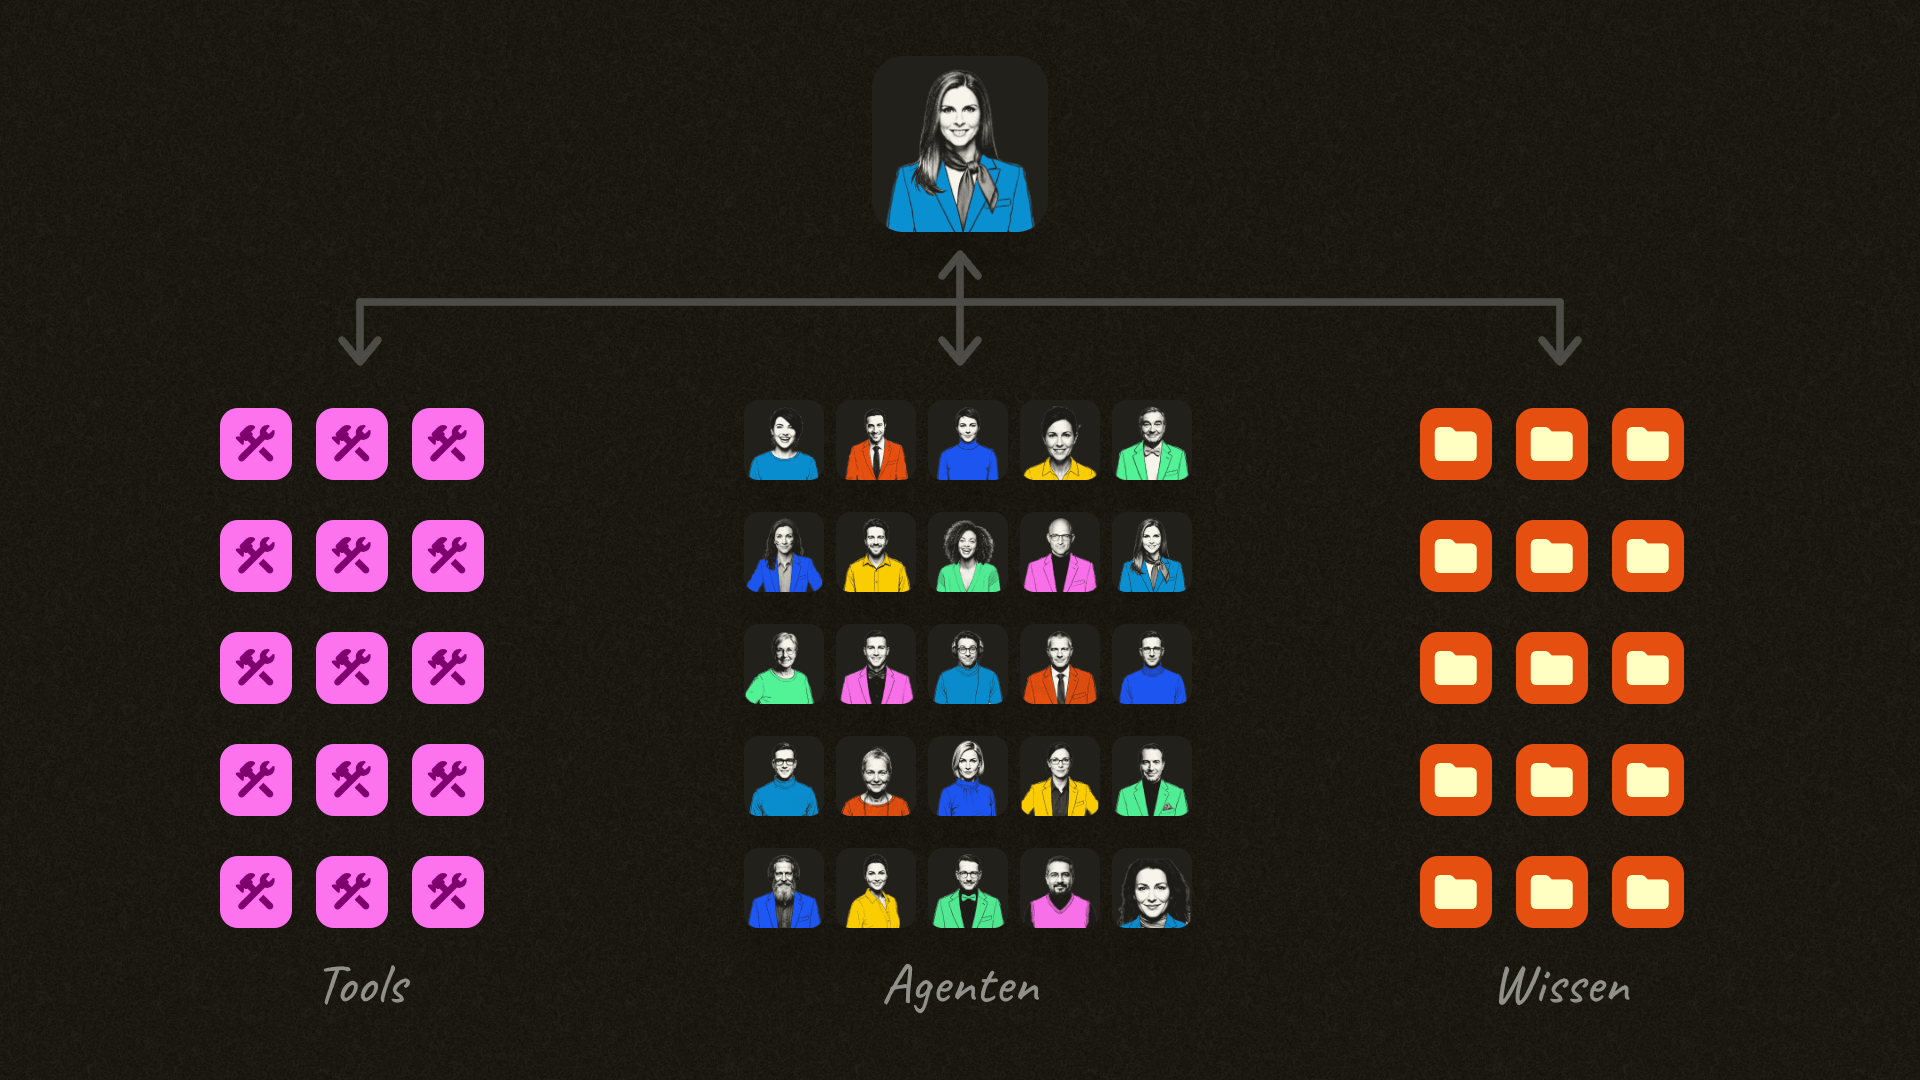
Mir war schnell klar, dass unser altes Playbook ausgedient hatte und es jetzt darum gehen wird, wie wir KI Zugriff auf all unsere Prozesse, allen Kontext, alle Systeme, unsere Regeln und Kriterien geben können, um eigenständig einen Großteil der Arbeit erledigen zu können, so wie wir es tun würden.
Das war der Beginn des KI-Betriebssystems.
Hier kannst du nachlesen, wie wir es damals aufgebaut haben.
Was funktionierte und was nicht
Wir hatten einen einzigen zentralen Agenten für das ganze Unternehmen aufgesetzt, der Zugriff hatte auf tausende Seiten Markdown-formatierten Kontext, ca. 100 dokumentierte Prozesse als Skills mit „Definition of Done“-Kriterien, Tools (Mail, Kalender, Projektmanagement, CRM, Meetings, …) und ein Governance Handbuch als Regelwerk.
Um den Agenten möglichst nah an diese Daten zu bringen und unnötige API-Calls zu vermeiden, haben wir alles in unserem Wissensmanagement-Tool Notion abgebildet, auch unser CRM haben wir dort nachgebaut. Notion baute zu diesem Zeitpunkt eine super KI-Integration und der Agent konnte das gesamte System steuern.
So weit, so gut.
Die ersten Monate waren wie ein kleiner Rausch, weil wir nicht mehr 25 KI-Agenten koordinieren und ständig überarbeiten mussten, sondern ein Agent das gesamte System nutzen und selbst überarbeiten konnte. Arbeiten fühlte sich nie produktiver an.
Wir bauten auch eine Pipeline aus: Meeting erledigt → Transkript dokumentiert → Aufgaben extrahiert → Agent sucht pro Aufgabe passenden Skill → führt Skill aus → dokumentiert Ergebnis.
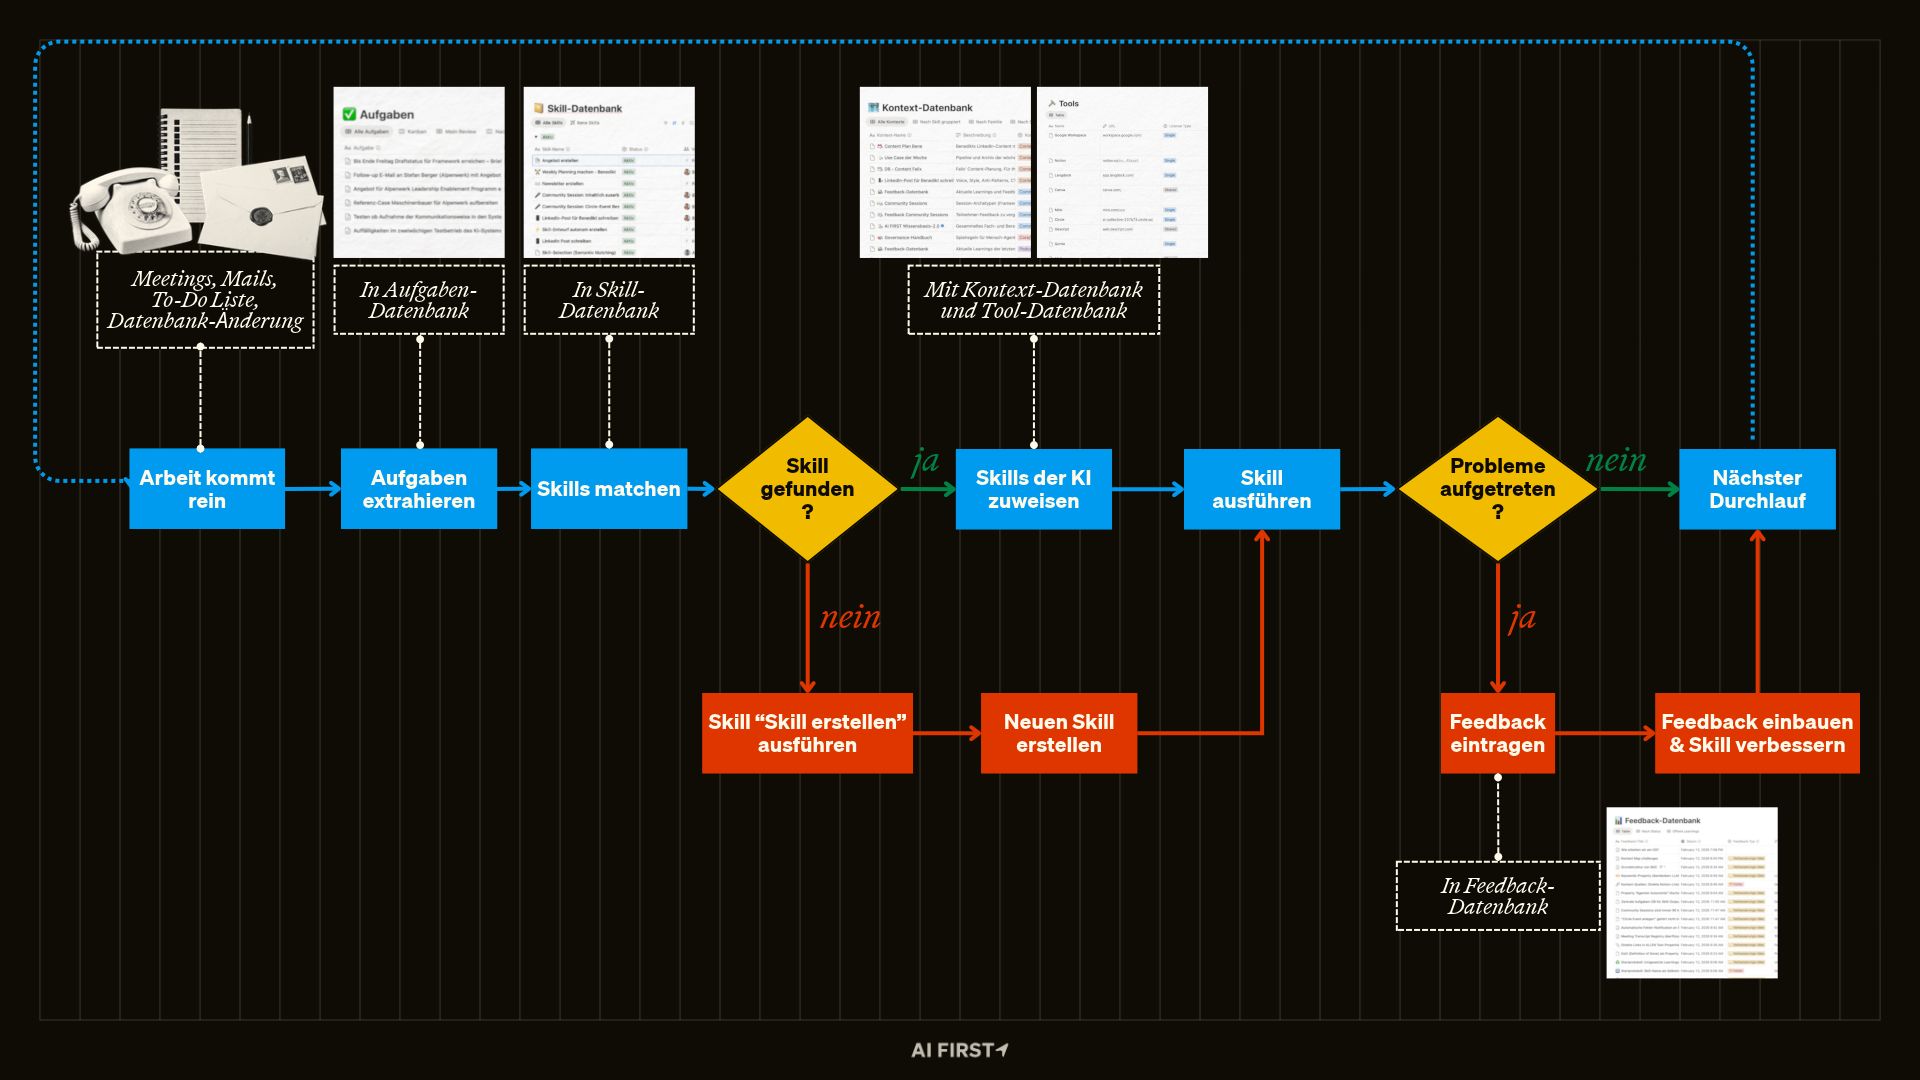
Eine ganze Zeit lang lief das gut, bis uns die Realität eines schnell wachsenden Unternehmens einholte.
Das waren die drei größten Probleme:
Problem 1: Veralteter Kontext
Wir hatten zu Beginn eine 1A Kontextbasis aufgebaut und mitgedacht, dass neuer Kontext (zB durch Meetings) angereichert wird. Zum Problem wurde, dass sich unser Unternehmen so schnell veränderte, dass wir mit der Aktualisierung nicht mehr hinterherkamen, unsere Mechaniken im Kontext-Layer nicht robust genug waren und der Agent irgendwann mit veraltetem Kontext gearbeitet hat — was natürlich permanent schlechte Ergebnisse liefert.
→ Jetzt gibt es einprogrammierte Routinen, um neuen Kontext anzureichern und bestehenden Kontext zu akualisieren.
Problem 2: Veraltete Skills
Wir hatten anfangs viel zu viele Skills aufgesetzt, die nicht ausreichend getestet waren. Oftmals für „Prozesse“, die überhaupt noch nicht robust, geschweige denn optimiert waren. Das Betriebssystem multiplizierte also unsere unoptimierten Prozesse und wir waren immer mehr mit der Nacharbeit beschäftigt — wir steckten wieder im System, statt am System zu arbeiten. Vorlagen veralteten und Qualitätskriterien änderten sich, aber wir kamen mit dem Nachziehen der Skills nicht hinterher.
→ Jetzt gibt es nur noch einen Bruchteil der ursprünglich 100 Skills, Evaluationen für jeden Skill und einen „OS-Check“, der jede Woche neue Skills vorschlägt und die bestehenden auf tatsächliche Nutzung prüft.
Problem 3: Ein Tool für Alles
Notion war großartig, um die systemischen Zusammenhänge abzubilden und den Agent effizient innerhalb dieses Systems arbeiten zu lassen, da keine externe KI oben drauf gesetzt werden musste. ABER: Notion ist weder ein CRM, noch ein richtiges Projektmanagement-Tool, noch eine wirkliche Datenbank. Da wir all diese Funktionen in einem Tool abbilden wollten, musste wir auch alle Einstellungen selbst definieren, die mit spezialisierten Tools mitgeliefert werden. Außerdem hat Notion keinen Coding-Agenten. Da wir in der Zwischenzeit immer mehr eigene Tools und unsere Plattform gebaut haben, arbeiteten wir in zwei unterschiedlichen Welten, die nicht integriert waren und in unterschiedlichem Kontext arbeiteten.
→ Wir haben den KI-Agenten aus Notion rausgezogen, mehr Kontext in GitHub gezogen und Spezialtools wie Attio als CRM eingeführt.
Das System an sich funktionierte, aber wenn Kontext, Skills und die im System abgebildeten Prozesse auseinander driften mit der Realität der täglichen Arbeit im Unternehmen, versickert der Mehrwert Monat für Monat. KI kann nicht mehr, sondern immer weniger Arbeit für uns erledigen. Wir waren mal wieder zum Engpass geworden. Nachdem wir über Monate Skills, Kontext, Prozesse immer wieder selbst nachzogen, entschied ich mich, das gesamte System noch einmal zu überdenken — denn das war definitiv noch nicht die Endstation.
Das Unternehmen, in dem KI am besten arbeiten kann
Im September habe ich entschieden, das KI-Betriebssystem 2.0 selbst zu bauen und nicht an mein Team zu delegieren. „Wer andere in die Zukunft führen will, muss selbst vorangehen“, dachte ich mir, blockte meinen Kalender und betrat das Rabbit Hole.
Als Nordstern habe ich mir eine Leitfrage gestellt:
Wie muss ein Unternehmen gebaut sein, damit KI darin einen möglichst großen Teil unserer Arbeit übernimmt, sich möglichst selbstständig darin bewegt und mitwächst, wenn sich unsere Arbeit, unsere Angebote und unsere Kunden verändern?
Ich bin überzeugt, dass sich jedes Unternehmen diese oder eine ähnliche Frage stellen sollte. Viele Aufgaben am Rechner erledigt KI heute schon schneller und oft besser als wir. Wer das nicht nutzt, konkurriert bald mit Unternehmen, die genau diese Arbeit viel effizienter erledigen und die gewonnene Zeit in neue Wertschöpfung stecken.
Aber KI kann das nicht einfach so. Sie braucht Zugriff auf all das, worauf auch ein Mensch zugreift, wenn er diese Aufgaben erledigt. Genau dafür bauen wir das KI-Betriebssystem.
Für die Version 2.0 habe ich deshalb jeden Baustein unter die Lupe genommen und mich gefragt:
- Wo lebt der Agent, und auf welcher Ebene arbeitet er?
- Wo liegt der Kontext, und wie greift der Agent darauf zu?
- Wie bleibt Kontext aktuell, also nicht nur ergänzt, sondern wirklich gepflegt?
- Welche Systeme brauchen wir, damit Prozesse robuster abgebildet werden als heute?
- Wie bleiben die Skills aktuell, und welche brauchen wir überhaupt noch?
- Wie bringen wir Automatisierung ins System, die nicht bricht, sobald sich Prozesse ändern?
Beantwortet habe ich diese Fragen nicht allein, sondern mit KI, in drei Schritten.
Erst die Schwachstellen. Zuerst hat eine KI unser komplettes Setup analysiert. Das ist der große Vorteil, wenn KI auf alles zugreifen kann: Sie sieht nicht nur einzelne Fehler, sondern auch die Zusammenhänge und Sollbruchstellen dazwischen.
Dann der Blick nach außen. Danach hat die KI ausgewertet, wie andere solche Systeme bauen: die Primärquellen von Anthropic, OpenAI und Cursor, Open-Source-Projekte wie Hermes und OpenClaw, diverse GitHub-Repositories und Ansätze wie das LLM-Wiki von Andrej Karpathy. Die Frage für jeden Baustein: Was machen alle gleich, und wo unterscheiden sie sich?
Zum Schluss streichen. Jeder Baustein musste durch eine Handvoll Prüfungen. Die wichtigste: der Weglass-Test („Was passiert, wenn wir ihn streichen?“). Lautete die ehrliche Antwort „nichts wird schlechter“, flog er raus. Das war nötig, weil wir in Version 1 viel zu viel gebaut hatten, das wir am Ende kaum nutzten aber verwalten mussten. Dieses mal galt: so einfach wie nur irgendwie möglich.
Daraus entstand ein Bauplan, den ich mit meinem Agenten in mehreren Etappen umgesetzt habe — während der Umsetzung entwickelten sich viele Inhalte dynamisch weiter, was mir wieder zeigt, dass anfangen viel wichtiger ist, als auf den perfekten Plan zu warten.
Das Ergebnis hat mich selbst etwas überrascht: Die Kernarchitektur aus Version 1 hat ziemlich gut gehalten, da wir diese schon damals von First Principles hergeleitet hatten. Wir haben nur einen zentralen Baustein „Automatisierungen“ ergänzt.
Die größten Veränderungen gab es innerhalb der einzelnen Bausteine und die Mechaniken zwischen den Bausteinen. Diesen Deep Dive machen wir in den kommenden Artikeln.
Fazit
Wir hatten ein KI-Betriebssystem gebaut, das nicht mit unserer Arbeit mitgewachsen ist. System und Realität drifteten auseinander — trotz einiger Mechaniken, die das verhindern sollten.
Version 1 war also noch nicht die Antwort auf die Frage:
Wie muss ein Unternehmen gebaut sein, damit KI darin einen möglichst großen Teil unserer Arbeit übernimmt, sich möglichst selbstständig darin bewegt und mitwächst, wenn sich unsere Arbeit, unsere Angebote und unsere Kunden verändern?
Habe ich sie jetzt gefunden? Ich weiß es nicht. Aber wir sind einen guten Schritt weitergekommen.
In den nächsten Wochen steigen wir tiefer ein:
- Aufbau KI-Betriebssystem 2.0
- Wie der Kontext-Layer mitwächst
- Welche Skills es noch gibt und wie wir Qualität sichern
- Automatisierungen und Routinen
- Welche Fragen noch offen sind
Schick mir auch gern deine Fragen!
Bis nächsten Sonntag,
Felix
P.S. Wir öffnen endlich wieder die Tore für neue Mitglieder im AI Collective! Dort baust du nicht nur dein persönliches KI-Setup und Betriebssystem, sondern hast Zugang zu wöchentlichen Community Sessions mit 150+ anderen KI-Verantwortlichen aus DACH, Coaching durch mich und mein Team, Live Trainings von Experten und und und.
Wir nehmen wieder nur maximal 30 Personen auf und 6 Plätze sind schon weg.
Hier geht’s zur Bewerbung.